 mozgi
Linum ha presentato l'architettura JiT-DDT per accelerare l'addestramento dei modelli di 3,6 volte
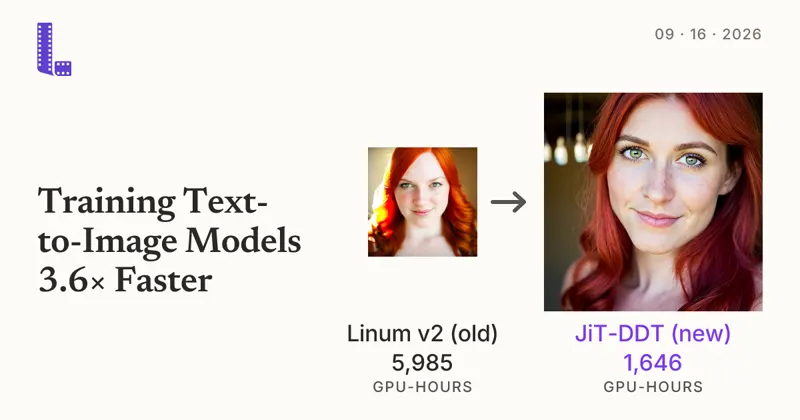
L'azienda Linum ha annunciato una nuova architettura JiT-DDT, progettata per ottimizzare il processo di apprendimento dei modelli generativi. La tecnologia consente di ridurre il tempo di preparazione delle reti neurali per la generazione di immagini in base a descrizioni testuali di 3,6 volte rispetto ai modelli standard di diffusione (Latent Diffusion Models).
La differenza chiave di JiT-DDT è il rifiuto di utilizzare il tradizionale "collo di bottiglia" sotto forma di VAE (Variational Autoencoder). Al suo posto, l'architettura combina i processi di compressione e generazione in una struttura unica. Il sistema applica una compressione aggressiva dei token fino alle dimensioni di 32x32, riducendo notevolmente il carico computazionale durante la fase di apprendimento.
I sviluppatori notano che questo approccio consente di lavorare efficacemente con dati spaziali senza perdita di qualità della generazione finale. L'integrazione della compressione direttamente nell'architettura del modello elimina la necessità di un pre-elaborazione dei dati attraverso encoder esterni, che spesso diventano un collo di bottiglia durante la scalabilità dell'apprendimento.
La nuova architettura è finalizzata a ridurre i costi e i tempi di sviluppo dei modelli generativi visivi. L'utilizzo di JiT-DDT consente ai ricercatori e agli ingegneri di eseguire più iterazioni di apprendimento con la stessa dotazione hardware, aspetto critico per la creazione di sistemi di generazione di immagini ad alte prestazioni.
Notizie correlate
 Un ricercatore di Anthropic ha valutato l'efficacia dell'IA nell'audit delle azioni degli agenti
7 novembre 2026
 È stata rilasciata la versione aggiornata del benchmark SWE-Bench Pro V2 per agenti IA
7 novembre 2026
 Il benchmark Into the Unknown rivela il fallimento degli agenti IA nella ricerca autonoma
7 novembre 2026
 Anthropic ha pubblicato una ricerca sull'architettura della memoria degli agenti IA
7 novembre 2026