 mozgi
Linum 提出了 JiT-DDT 架構來加速模型訓練速度達 3.6 倍
2026年9月16日
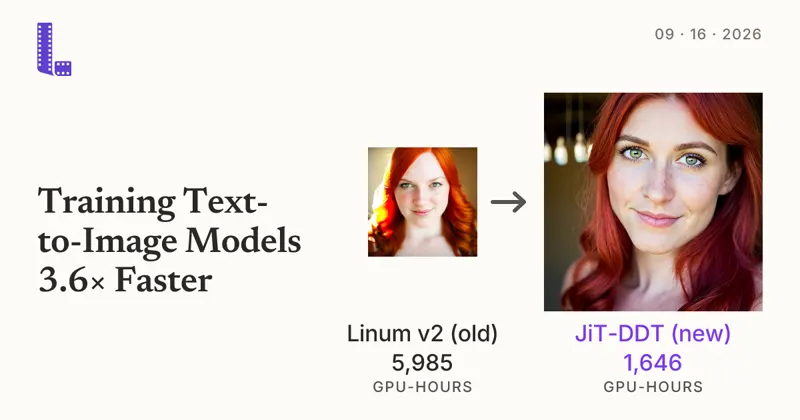
公司 Linum 宣布了一種新的架構 JiT-DDT,旨在優化生成模型的訓練過程。該技術可以將基於文本描述的圖像生成的神經網絡準備時間縮短 3.6 倍,相比於標準的擴散模型(Latent Diffusion Models)。
JiT-DDT 的關鍵區別在於放棄使用傳統的「瓶頸」—— VAE(變分自編碼器)。相反,該架構將壓縮和生成過程合併為一個單一結構。系統對令牌進行激進壓縮,壓縮到 32x32 的大小,大大降低了訓練階段的計算負荷。
開發人員指出,該方法可以在不損失最終生成質量的情況下有效地處理空間數據。將壓縮直接集成到模型架構中,消除了通過外部編碼器進行預處理數據的需要,而這些編碼器在擴展訓練時往往成為瓶頸。
新的架構旨在降低視覺生成模型的開發成本和時間。使用 JiT-DDT 可以讓研究人員和工程師在相同的硬件上進行更多次的訓練迭代,這對於創建高性能的圖像生成系統至關重要。



