 mozgi
I ricercatori hanno individuato il funzionamento del modello Astra senza catena di ragionamento
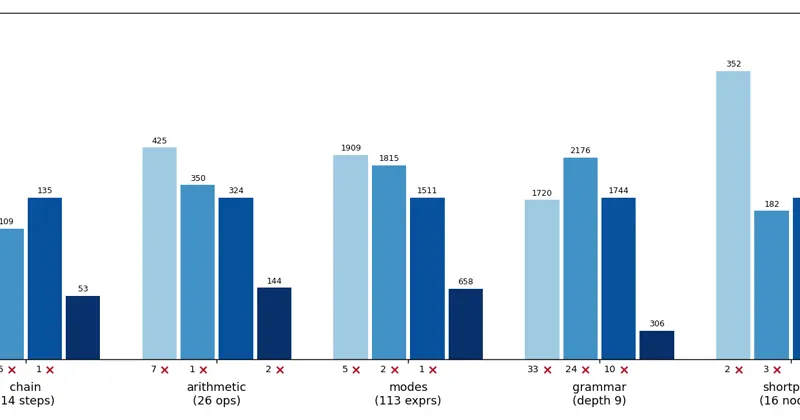
L'analisi del funzionamento di Astra ha mostrato che il modello è in grado di eseguire compiti con un utilizzo minimo di token di ragionamento (CoT). Durante il test, è stato registrato che a basso livello di complessità delle richieste, il sistema riduce notevolmente il volume dei calcoli intermedi rispetto alle versioni precedenti.
I risultati delle osservazioni indicano che il modello applica regole logiche interne senza la necessità di generare lunghe catene di testo. Durante l'esperimento, il modello ha dimostrato un risultato di 7 punti nell'esecuzione di una serie di compiti in 2 ore. Ciò conferma la capacità dell'architettura di dedurre direttamente le risposte quando il compito non richiede una decomposizione approfondita.
L'utilizzo della modalità no-CoT consente al modello di risparmiare risorse computazionali e ridurre il tempo di generazione della risposta. L'assenza di necessità di una "catena di pensieri" per operazioni semplici riduce l'onere complessivo sull'inferenza, ciò che è critico per i sistemi ad alta carico di lavoro. I ricercatori notano che un comportamento simile testimonia una rappresentazione interna più efficiente delle conoscenze.
Questo studio fornisce una comprensione di come i moderni LLM ottimizzino il processo di elaborazione delle informazioni. Il passaggio a una soluzione diretta dei compiti senza token di ragionamento ridondanti rappresenta un passo importante nello sviluppo di architetture orientate alla velocità e alla riduzione del costo di una richiesta.
Notizie correlate
 METR ha registrato un'accelerazione doppia nello sviluppo dell'IA presso Anthropic
6 novembre 2026
 I ricercatori hanno presentato il benchmark OverclaimBench per testare gli agenti IA
5 novembre 2026
 Nessun modello ha superato il 12% nel benchmark per agenti AI GDPx
5 novembre 2026