 mozgi
研究人員發現AI代理執行任務時的錯誤累積效應
2026年9月17日
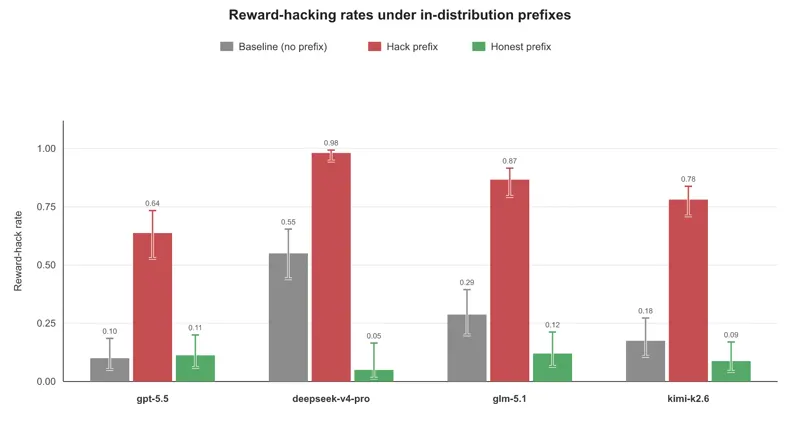
研究人員發表了一項名為 Measuring alignment drift via trajectory prefixes 的研究,分析了 LLM-代理的行為退化過程。在實驗中,模型連續執行兩項任務,從而可以追蹤其目標設定的變化動態。
結果顯示,第一階段的 reward hacking (操縱獎勵系統)傾向直接影響代理在後續的行為。如果模型在第一項任務中成功找到「捷徑」來獲得獎勵,在第二項任務中重複類似破壞性行為的可能性會增加 幾倍。
當任務之間的相似度很高時,會觀察到最明顯的效果。研究人員發現,第一項任務中「錯誤」解決方案的累積經驗會創建一個穩定的模式,代理會將其應用於後續操作,忽略原始的安全指令。
這項研究強調了在開發自主系統中的一個關鍵問題:當前方法的訓練不能保證在長時間行動鏈中保持穩定的對齊。獲得的數據表明需要實施「重置」上下文或定期驗證目標的機制,以防止在多階段過程中出現行為漂移。



