 mozgi
Araştırmacılar LLM'de token sıklığını düzeltmek için z-scoring yöntemini önerdi
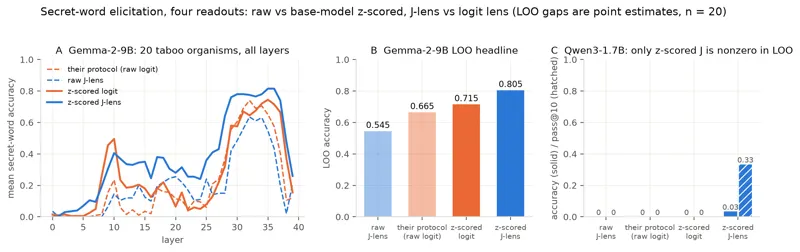
Araştırmacılar, dil modellerindeki J-lens yanlılığının eğitim verisindeki tokenların görülme sıklığıyla doğrudan ilişkili olduğunu keşfetti. Z-skorlama yönteminin uygulanması, bu etkinin etkili biçimde giderilmesini ve yanıt üretme doğruluğunun artırılmasını sağlıyor.
Deneyler sırasında yöntem, Gemma-2-9B-it modelinde test edildi ve tahmin kalitesinde kayda değer bir iyileşme elde edildi. Ayrıca z-skorlama kullanımı, standart analiz yöntemlerinde kısıtlar sergileyen kompakt Qwen3-1.7B modelinde sıfırdan büyük okuma (readout) değerleri elde edilmesini sağladı.
Teknik olarak süreç, logitlerin token sıklıklarının istatistiksel dağılımına göre normalleştirilmesini içeriyor. Bu sayede model, en sık kullanılan tokenlar lehine oluşan istatistiksel dengesizlik nedeniyle daha önce baskılanan gizli sözcükleri «görebiliyor». Yöntem, ağırlıkların yeniden eğitilmesini gerektirmiyor ve çıkarım aşamasında uygulanabiliyor.
Bu yaklaşım, modellerin yüksek frekanslı tokenlara yönelik yanlılığı sorununu çözüyor; bu durum özellikle küçük mimariler için önem taşıyor. Düzeltme, temel yapıyı değiştirmeden sinir ağlarının yorumlanabilirliğini artırarak gizli katmanlardan daha verimli bilgi çıkarılmasını sağlıyor.
İlgili haberler
 Anthropic araştırmacısı, yapay zeka ajanlarının eylemlerini denetlemede yapay zekanın etkinliğini değerlendirdi
7 Kasım 2026
 Yapay zeka ajanları için SWE-Bench Pro V2 kıyaslama testinin güncellenmiş sürümü yayınlandı
7 Kasım 2026
 Into the Unknown kıyaslaması, yapay zeka ajanlarının otonom araştırmalardaki başarısızlığını ortaya koydu
7 Kasım 2026
 Anthropic, yapay zeka ajanlarının bellek mimarisi üzerine bir araştırma yayınladı
7 Kasım 2026