 mozgi
I ricercatori hanno valutato l'efficacia del metodo R-Lens per i modelli Qwen
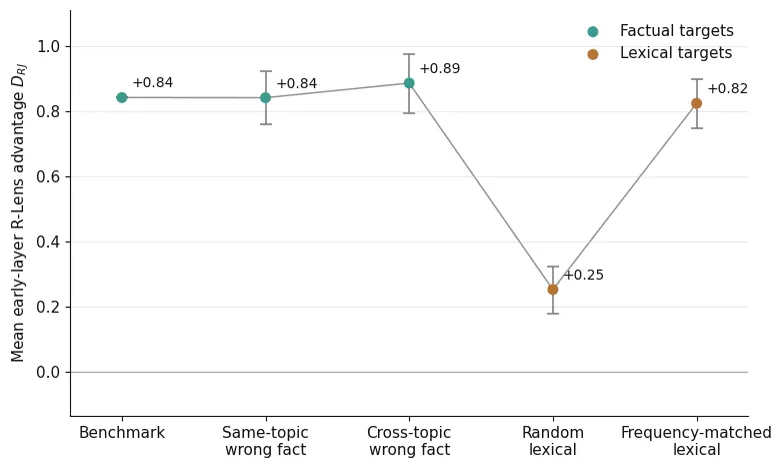
I ricercatori hanno condotto un test del metodo R-Lens, progettato per estrarre fatti nascosti dai pesi dei modelli linguistici della famiglia Qwen. Durante l'esperimento, è stata valutata la capacità dell'algoritmo di classificare le parole bersaglio in confronto all'approccio esistente J-Lens.
I risultati hanno mostrato che R-Lens presenta tassi di classificazione più alti per i token bersaglio. Tuttavia, le misurazioni di controllo hanno rivelato che il vantaggio del metodo è direttamente correlato alla freqenza delle parole nel set di dati di training, e non con la profondità di estrazione di conoscenze fattuali specifiche dai parametri del modello.
Nel quadro del lavoro, sono stati analizzati i meccanismi di attivazione dei neuroni durante le richieste volte a cercare informazioni nascoste. È emerso che le distribuzioni statistiche dei token in Qwen hanno un impatto maggiore sul risultato rispetto alle presunte "conoscenze nascoste" che l'algoritmo tenta di interpretare.
Questo studio mette in discussione l'efficacia dei metodi di interpretazione attuali basati sulla ricerca diretta di fatti nei pesi. I dati raccolti indicano la necessità di considerare le distorsioni di frequenza nella progettazione di strumenti per l'analisi della struttura interna degli LLM.
Notizie correlate
 Un ricercatore di Anthropic ha valutato l'efficacia dell'IA nell'audit delle azioni degli agenti
7 novembre 2026
 È stata rilasciata la versione aggiornata del benchmark SWE-Bench Pro V2 per agenti IA
7 novembre 2026
 Il benchmark Into the Unknown rivela il fallimento degli agenti IA nella ricerca autonoma
7 novembre 2026
 Anthropic ha pubblicato una ricerca sull'architettura della memoria degli agenti IA
7 novembre 2026