 mozgi
ByteShape ha rilasciato versioni quantizzate del modello Qwen 3.8 27B
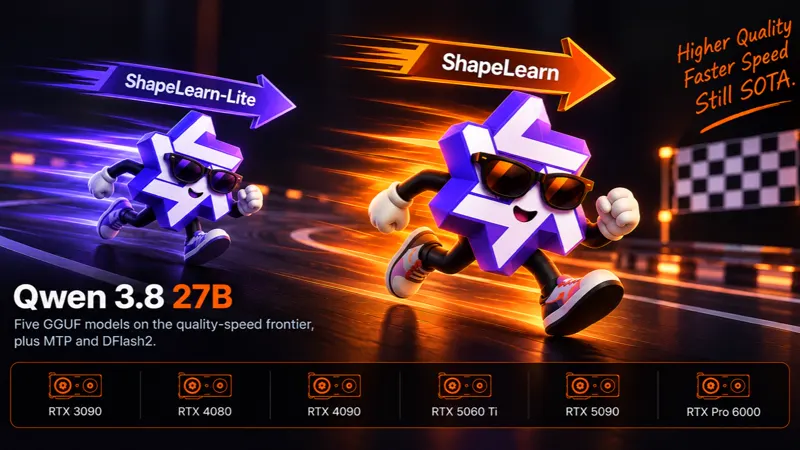
L'azienda ByteShape ha presentato una serie di versioni quantizzate GGUF del modello linguistico Qwen 3.8 27B. Il rilascio è finalizzato all'ottimizzazione del funzionamento del modello in condizioni di risorse hardware limitate, mantenendo un'elevata precisione di generazione.
La configurazione principale GPU-5 (IQ4_XS) richiede 13,1 GB di VRAM e mostra prestazioni a livello di 90,4 token al secondo. Secondo i test interni, la qualità delle risposte di questa versione è del 99,63% rispetto al modello originale nel formato BF16. Il processo di formazione e calibrazione dei pesi ha richiesto 9 ore, al termine delle quali il modello ha raggiunto 71 punti nei benchmark di riferimento.
Per i sistemi con limiti di memoria ancora più stringenti, è disponibile la versione GPU-4. Questa versione consuma 11,0 GB di VRAM e garantisce una velocità di inferenza aumentata grazie a una compressione più aggressiva dei parametri. Entrambe le versioni sono disponibili per la distribuzione locale tramite gli strumenti standard di supporto per il formato GGUF.
I dettagli tecnici e i risultati dei test della community sono discussi sulla piattaforma Hacker News. L'utilizzo della quantizzazione consente di eseguire modelli di classe 27B su schede grafiche consumer di fascia media, riducendo la soglia di accesso per l'uso locale di LLM pesanti.
Notizie correlate
 Qwen ha rilasciato il modello open Qwen3.8 con un contesto di 1M di token
7 novembre 2026
 Google ha rilasciato il modello Lyria 3.5 per la generazione di musica
6 novembre 2026
 MiniMax ha rilasciato il generatore video H3
6 novembre 2026
 Thinking Machines ha rilasciato il modello Inkling 2 Small
6 novembre 2026