 mozgi
Hugging Face ha presentato il metodo di apprendimento asincrono GRPO con LoRA
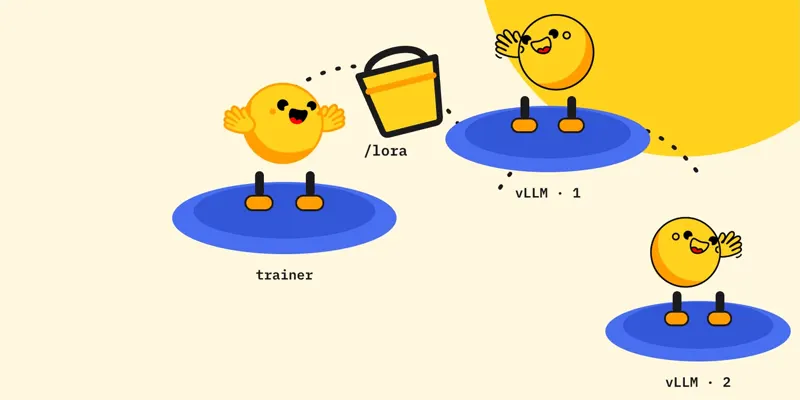
Il team di Hugging Face ha pubblicato una soluzione architettonica per l'addestramento distribuito di modelli utilizzando l'algoritmo GRPO (Group Relative Policy Optimization) e gli adattatori LoRA. Il metodo consente di eseguire l'addestramento senza utilizzare il protocollo NCCL, sostituendolo con un'interazione tramite archiviazione oggetti e server proxy.
Il principale problema dell'addestramento tradizionale consiste nella rigida sincronizzazione dei nodi, che porta a tempi di inattività quando uno di essi si guasta. Il nuovo approccio utilizza un modello asincrono: ogni nodo lavora in modo indipendente, salvando i pesi intermedi in un bucket cloud. Ciò elimina la necessità di una connessione di rete costante tra le GPU, che è critica per i cluster instabili.
Nell'implementazione viene utilizzato LoRA per minimizzare il volume dei dati trasmessi. Invece di sincronizzare i pesi completi del modello, i nodi scambiano solo i gradienti degli adattatori, riducendo il carico di rete di decine di volte. Il sistema è stato testato sull'infrastruttura HF Jobs, dove è stato possibile raggiungere un addestramento stabile con il collegamento e la disconnessione dinamica delle risorse di calcolo.
L'assenza di dipendenza da NCCL consente di avviare l'addestramento su GPU eterogenee, che non sono unite in una rete ad alta velocità unica. Questa soluzione riduce la soglia di ingresso per il riaddestramento di grandi modelli linguistici, poiché consente di utilizzare istanze cloud disparate senza una complessa configurazione della topologia di rete.
Questo approccio cambia l'approccio al ridimensionamento dell'addestramento, rendendo il processo resistente ai guasti dell'hardware. Ora gli sviluppatori possono avviare cicli di addestramento lunghi senza temere la perdita di progressi in caso di interruzione del lavoro di singoli nodi nel cluster.
Notizie correlate
 Google ha insegnato agli smartwatch a rilevare la pressione alta senza bracciale
7 novembre 2026
 Un ricercatore ha ottenuto l'accesso completo al firmware dei Meta Ray-Ban
6 novembre 2026
 OpenAI ha aperto le chiamate SIP in uscita a tutte le organizzazioni
6 novembre 2026
 Replit ha aggiornato il motore sandbox basato su microVM
6 novembre 2026