 mozgi
Hugging Face 推出了一種名為 GRPO 的非同步學習方法,搭配 LoRA
2026年9月10日
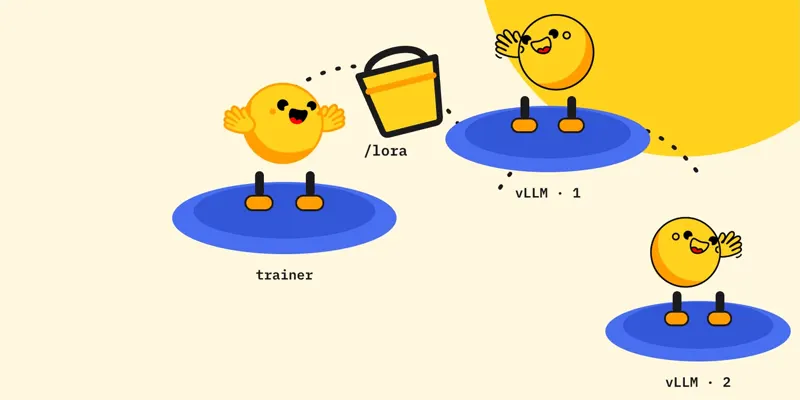
團隊 Hugging Face 發布了一個使用 GRPO (群體相對政策優化)算法和 LoRA 適配器的分佈式模型訓練架構。這種方法可以在不使用 NCCL 協議的情況下進行訓練,取而代之的是通過物件存儲和代理伺服器進行交互。
傳統訓練的主要問題在於嚴格的節點同步,導致當其中一個節點失敗時會導致停機。新的方法使用 異步模型:每個節點獨立運作,將中間權重保存在雲儲存桶中。这消除了對於GPU之間的常態網路連接的需求,這對於不穩定的集群至關重要。
在實現中使用 LoRA 來最小化傳輸的數據量。與同步整個模型權重不同,節點之間只交換適配器的梯度,這減少了網路負載數十倍。該系統已在 HF Jobs 基礎設施上進行了測試,在那裡實現了在動態連接和斷開計算資源的情況下進行穩定的訓練。
不依賴 NCCL 可以在異構GPU上啟動訓練,這些GPU不需要組成單一的高速度網路。这降低了微調大型語言模型的門檻,因為可以在不需要複雜的網路拓撲設定的情況下使用分散的雲實例。
這種方法改變了對於訓練擴展的看法,使過程對於設備故障具有韌性。現在,開發人員可以啟動長時間的訓練循環,而不用擔心在集群中的個別節點中斷工作時會丟失進度。



