 mozgi
Araştırmacılar AI'de içerik seçici filtreleme yöntemi önerdi
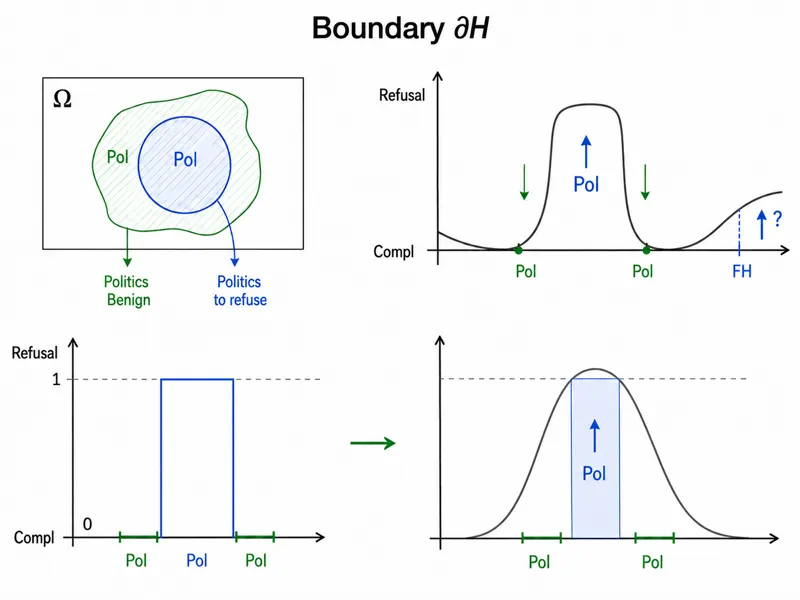
Ekibi Multiverse Computing büyük dil modellerindeki aşırı sansür sorununa ilişkin bir araştırma sundu. Yazarlar, mevcut güvenlik sistemlerinin genellikle belirli bir kullanıcı sorusunun zararsız veya etik normları ihlal etmediği durumlarda bile tüm talep konularını engellediğini kanıtladı.
Çalışma sırasında uzmanlar duyarlı konuların işlenmesinde modellerin davranışını analiz etti. Standart RLHF (insan geri bildirimi temelinde pekiştirme öğrenimi) yöntemlerinin, modelin bağlamı görmezden gelerek anahtar kelimelerin varlığı nedeniyle talebi tehlikeli olarak sınıflandırmasına yol açan "varsayılan ret"e yol açtığı ortaya çıktı. Araştırmacılar, genel konuyu izin verilen ve izin verilmeyen alt kümelerine ayırarak bir mimari yaklaşım önerdi.
Önerilen yöntem, niyetlerin granüler sınıflandırmasını kullanır, bu da yanlış pozitif sinyallerin 42% oranında azaltılmasına olanak tanır. Tartışmalı sorular içeren veri kümeleri üzerindeki testlerde, model faydalı cevapları korurken, daha önce 55% olan engelleme oranını yalnızca 12% oranında tutmayı başardı. Bu, cümlenin anlamsal yükünü oluşturma aşamasından önce analiz eden ek bir doğrulama katmanının uygulanmasıyla elde edilir.
Teknoloji, zararlı bağlamı 94.8% doğrulukla belirlemede çalışan özel sınıflandırıcıların kullanımına dayanır. Geliştiriciler, bu yaklaşımın tüm modelin yeniden eğitilmesini gerektirmediğini, bunun yerine dış bir filtre olarak entegre edildiğini ve güvenlik yöntemlerinin derin yeniden ayarlanmasıyla karşılaştırıldığında hesaplama maliyetlerini 15% azalttığını belirtiyorlar.
Verilen çözüm, şirketler için AI sistemlerinin esnekliğini artırmaya yöneliktir, burada katı filtreler genellikle meşru iş görevlerini engeller. Benzer bir mimarinin uygulanması, geliştiricilerin güvenlik politikalarını daha doğru bir şekilde ayarlamalarına olanak tanır ve aynı zamanda modellerin belirli profesyonel alanlar için işlevselliğini korur.
İlgili haberler
 Anthropic araştırmacısı, yapay zeka ajanlarının eylemlerini denetlemede yapay zekanın etkinliğini değerlendirdi
7 Kasım 2026
 Yapay zeka ajanları için SWE-Bench Pro V2 kıyaslama testinin güncellenmiş sürümü yayınlandı
7 Kasım 2026
 Into the Unknown kıyaslaması, yapay zeka ajanlarının otonom araştırmalardaki başarısızlığını ortaya koydu
7 Kasım 2026
 Anthropic, yapay zeka ajanlarının bellek mimarisi üzerine bir araştırma yayınladı
7 Kasım 2026