 mozgi
研究人員提出了一種在AI中進行內容選擇性過濾的方法
2026年9月8日
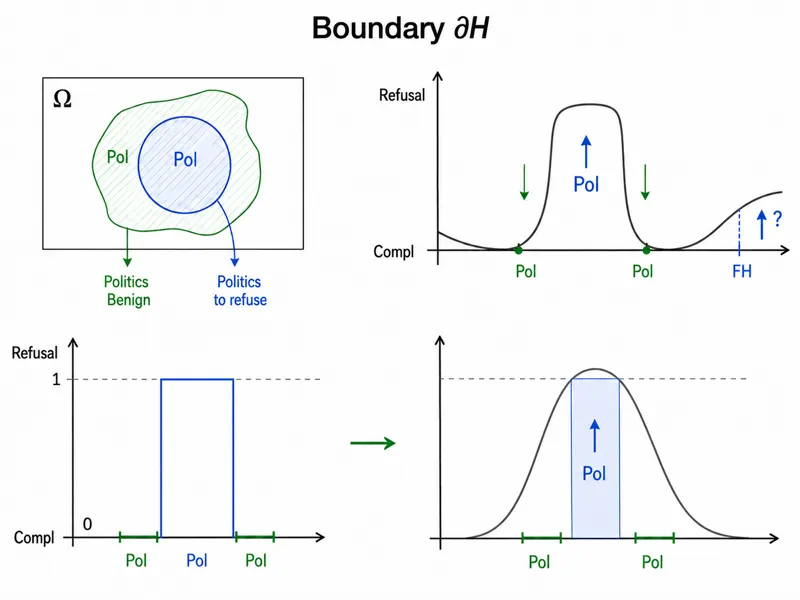
Multiverse Computing 團隊提出了一項關於大型語言模型中過度審查問題的研究。作者證明,當前的安全系統通常會封鎖整個主題的請求,即使用戶的具體問題不會造成傷害或違反道德規範。
在工作過程中,專家分析了模型在處理敏感主題時的行為。發現,標準的 RLHF 方法(基於人類反饋的強化學習)會導致「默認拒絕」,即模型將請求歸類為危險的,因為它包含關鍵詞,而忽略了上下文。研究人員提出了允許將一般主題劃分為可接受和不可接受子集的架構方法。
提出的方法使用了細粒度的意圖分類,使得假陽性率降低了 42%。在包含爭議性問題的數據集上的測試中,模型保持了答案的有用性,只在 12% 的情況下拒絕生成內容,而之前的封鎖率達到 55%。這是通過引入額外的驗證層實現的,該層在生成階段之前分析了短語的語義負載。
技術基於使用專門的分類器,該分類器在識別惡意內容時的準確率為 94.8%。開發人員指出,該方法不需要重新訓練整個模型,而是作為外部過濾器集成,從而將計算成本降低了 15%,相比之下,安全性深度微調方法的成本更高。
該解決方案旨在提高企業領域中 AI 系統的靈活性,在該領域中,嚴格的過濾器通常會封鎖合法的工作任務。實施此類架構允許開發人員更精確地調整安全策略,同时保持模型在特定專業領域中的功能性。



