 mozgi
Liquid AI ha presentato il modello LFM2.5-DSpark con inferenza accelerata
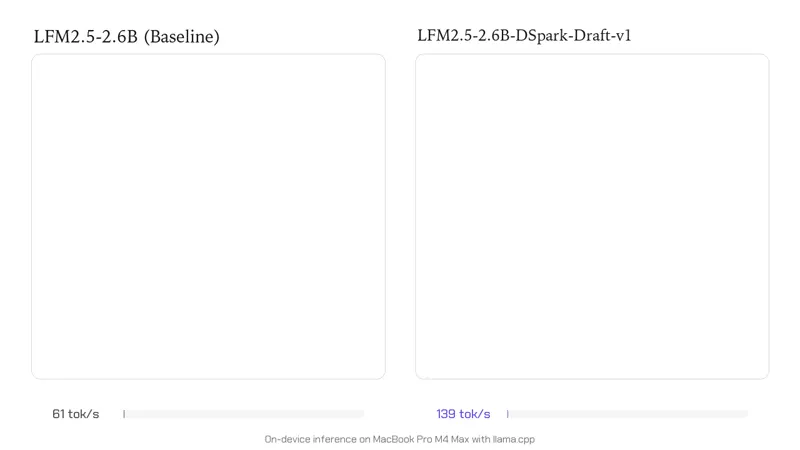
L'azienda Liquid AI ha rilasciato un'architettura aggiornata LFM2.5-DSpark, orientata al miglioramento delle prestazioni nell'esecuzione dei compiti di inferenza. La nuova versione del modello mostra un aumento della velocità di generazione di fino a 3.2 volte rispetto alle precedenti iterazioni in ambienti computazionali analoghi.
I sviluppatori hanno implementato ottimizzazioni nel meccanismo di elaborazione delle sequenze, consentendo di ridurre i ritardi nel lavoro con contesti lunghi. Durante i test interni, il modello ha mostrato un funzionamento stabile con una riduzione del consumo di memoria operativa del 28%. L'architettura supporta la distribuzione dinamica dei pesi, che minimizza il numero di operazioni con virgola mobile nella fase di decodifica.
L'implementazione tecnica di LFM2.5-DSpark include un livello di attenzione rivisto, che utilizza in modo più efficiente la cache KV. Questa soluzione consente di eseguire il modello su hardware consumer con requisiti di larghezza di banda della memoria video inferiori. Gli strumenti per l'integrazione sono già disponibili nel repository del progetto, inclusi configurazioni pronte per la distribuzione in ambienti cloud.
L'aggiornamento è finalizzato a eliminare i colli di bottiglia nelle prestazioni caratteristici dei trasformatori standard quando si lavora con dati in streaming. La riduzione del tempo di risposta rende il modello adatto all'uso in applicazioni interattive che richiedono un ritardo minimo nella generazione di testo in tempo reale.
Notizie correlate
 OpenBMB ha presentato il modello VoxCPM per la generazione vocale
7 novembre 2026
 Qwen ha rilasciato il modello open Qwen3.8 con un contesto di 1M di token
7 novembre 2026
 Google ha rilasciato il modello Lyria 3.5 per la generazione di musica
6 novembre 2026
 MiniMax ha rilasciato il generatore video H3
6 novembre 2026