 mozgi
Hugging Face 推出了一種透過程式碼訓練模型繪圖的方法
2026年9月3日
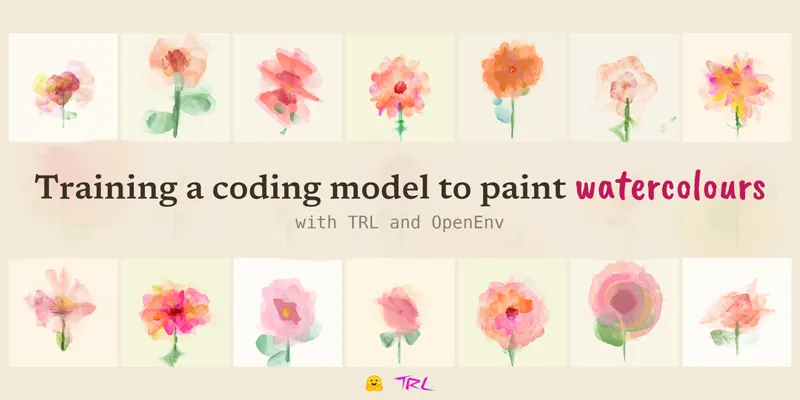
團隊 Hugging Face 發佈了一種使用程式碼訓練語言模型生成水彩圖像的方法。該過程基於使用 TRL (Transformer Reinforcement Learning) 庫和 OpenEnv 環境,允許代理與圖形引擎交互。
該方法的基礎是將繪畫命令轉換為模型生成的令牌序列,以控制虛擬筆刷。系統使用 PPO (Proximal Policy Optimization) 進行模型的微調,目標函數是生成圖像與指定參考圖像的視覺相似度。在實驗中,模型在一個包含 5000 個唯一筆畫和色彩調色板的數據集上進行了訓練。
技術實現包括 OpenEnv 的整合,以模擬畫布,允許模型在實時獲得反饋。使用 TRL 保證了在處理離散動作(如選擇坐標、筆刷壓力和顏料透明度)時的穩定性。訓練是在使用 8 GPU NVIDIA A100 的集群上進行的,達到了算法在 12 小時 內收斂。
該方法展示了通過文本模型控制視覺內容的可能性,而無需使用擴散過程。開發人員指出,該方法允許創建可解釋的圖像,其中每個元素都是執行特定程式指令的結果。工具包可用於集成到現有的強化學習代理訓練管道中。


