 mozgi
Gli sviluppatori hanno presentato lo standard di codifica UTF-8000
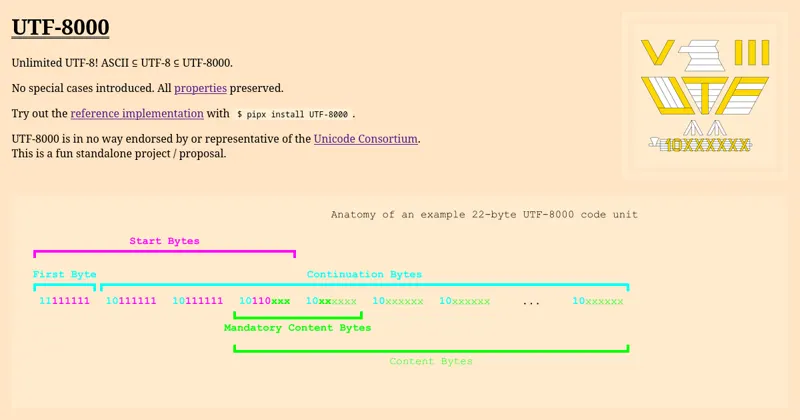
I sviluppatori hanno rilasciato UTF-8000 — un'estensione della codifica standard UTF-8, progettata per supportare unità di codice di dimensioni arbitrariamente grandi. Il progetto risolve il problema delle limitazioni dell'attuale standard quando si lavora con sequenze di dati estremamente lunghe.
La tecnologia implementa un meccanismo di distribuzione dei bit iniziali ai byte di continuazione. Ciò consente di codificare dati di qualsiasi dimensione, mantenendo al contempo la piena compatibilità con ASCII e le proprietà di base di UTF-8. Lo strumento è già disponibile per l'integrazione tramite il gestore di pacchetti pipx.
L'implementazione dello standard è orientata ai sistemi che richiedono l'elaborazione di set di caratteri non standard o formati di dati specifici che escono dall'ambito della specifica Unicode. Il codice sorgente e la documentazione del progetto sono stati pubblicati sul sito ufficiale, dove si svolge anche la discussione degli aspetti tecnici dell'implementazione di UTF-8000 negli ambienti di programmazione esistenti.
L'implementazione di questo standard consente agli sviluppatori di aggirare le limitazioni sulla lunghezza delle sequenze di codice senza dover passare a metodi di serializzazione alternativi. Ciò semplifica il lavoro con sistemi ad alta carico, dove è richiesta la trasmissione di dati che superano i limiti standard di codifica.
Notizie correlate
 Google ha insegnato agli smartwatch a rilevare la pressione alta senza bracciale
7 novembre 2026
 Un ricercatore ha ottenuto l'accesso completo al firmware dei Meta Ray-Ban
6 novembre 2026
 OpenAI ha aperto le chiamate SIP in uscita a tutte le organizzazioni
6 novembre 2026
 Replit ha aggiornato il motore sandbox basato su microVM
6 novembre 2026