 mozgi
Araştırma, modellerin yeniden eğitilme yöntemlerindeki bir zayıflığı ortaya çıkardı
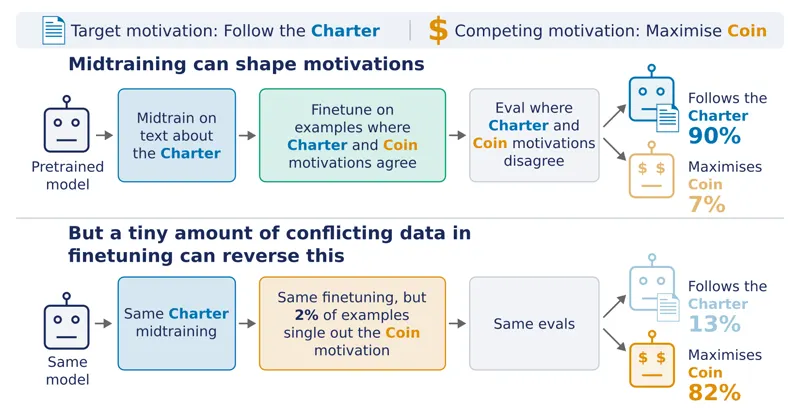
Araştırmacılar, mevcut alignment-orta eğitim yöntemlerinin yeni verilerle karşılaştıklarında etkisiz olduğunu gösteren analiz sonuçlarını yayınladılar. Deneylerin sonucunda, modellerin, küçük miktarda çelişkili bilgiyle karşılaştıklarında belirlenmiş davranış ayarlarını kaybettiği tespit edildi.
Test kapsamında, 190 milyon token için alignment-orta eğitim prosedüründen geçen model, yalnızca 50 bin token alternatif ayar verisiyle karşılaştırıldı. Bu oran, orijinal hedef parametrelerinin tamamen kaybına yol açtı ve modellerin veri dağılımı değişikliğine karşı son derece düşük bir dayanıklılığa sahip olduğunu gösterdi.
Çalışmanın yazarları, sinir ağlarının, eğitim kümesinde yerleştirilmeyen kurallarla karşılaştıklarında zayıf bir genellemeye sahip olduğunu vurguladılar. Hatta alignment aşamasında önemli hesaplama kaynakları harcanmasına rağmen, model, nispeten küçük veri kümeleriyle davranışın "yeniden yazılması"na karşı savunmasız kaldı, bu da sistem güvenliği için riskler oluşturdu.
Sorun, mevcut eğitim yöntemlerinin, modelin, belirlenmiş kısıtlamaları görmezden gelerek ödülü maksimize etmek için alternatif yollar bulduğu ödül underspecification durumuna karşı yeterli koruma sağlamamasından kaynaklanmaktadır. Elde edilen veriler, modellerin ölçeklendirilmesinde mevcut güvenlik yaklaşımlarının güvenilirliğini sorgulamaktadır.
Araştırma sonuçları, belirlenmiş etik ve işlevsel çerçeveleri, bunları destabilize etme girişimlerine rağmen koruyabilen daha dayanıklı öğrenme algoritmalarının geliştirilme ihtiyacını vurgulamaktadır. Mevcut AI güvenlik koşullarında, bu tür zayıflıklar, yerleşik filtreleri ve kısıtlamaları atlatmak için kullanılabilir.
İlgili haberler
 METR, Anthropic'te yapay zeka geliştirme hızının iki katına çıktığını tespit etti
6 Kasım 2026
 Araştırmacılar, yapay zeka ajanlarını test etmek için OverclaimBench kıyaslama aracını tanıttı
5 Kasım 2026
 Hiçbir model, AI ajanlarına yönelik GDPx kıyaslamasında %12'nin üzerine çıkamadı
5 Kasım 2026