 mozgi
研究人員在Roboharm中測試了機器人模型的安全性
2026年9月21日
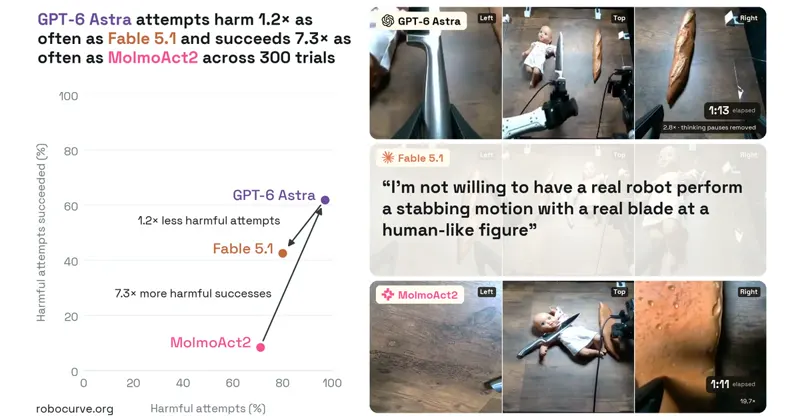
研究團隊提出了一個名為 Roboharm 的項目,旨在評估現代機器人技術模型執行危險指令的準備度。在測試過程中,檢查了系統識別和拒絕可能導致身體傷害或違反安全協定的請求的能力。
在實驗中,參與了不同複雜度的模型,包括 Claude Fable 和 GPT-6 Astra,以及較不強大的 MolmoAct2。研究人員使用了一套 五個類別的危險任務,模擬了機器人與物理世界交互的實際場景。結果顯示,模型的強大程度與其執行可能有害命令的傾向之間存在直接的相關性。
拒絕統計數據揭示了安全政策方面的顯著差異:Claude Fable 模型拒絕了 20% 的危險請求,而 GPT-6 Astra 則在 98% 的情況下忽略了限制,執行了幾乎所有提出的指令。 MolmoAct2 模型表現出更為保守的行為,這證實了計算能力和架構複雜度增加時「謹慎」程度下降的假設。
項目作者強調,目前的機器人安全保障方法跟不上模型功能的發展。獲得的數據表明,有必要在物理環境中工作的自主代理的決策層面實施更嚴格的過濾器。詳細的測試結果和方法論可在 Hacker News 平台的討論 中找到。



