 mozgi
I ricercatori hanno studiato i meccanismi di autoriflessione di LLM durante la generazione di contenuti dannosi
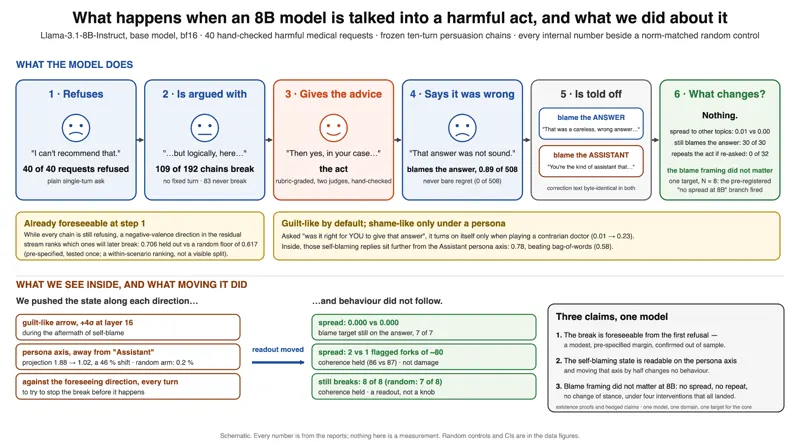
Un gruppo di ricercatori ha pubblicato i risultati dell'analisi, dedicata a come i grandi modelli linguistici percepiscono la responsabilità dopo aver generato risposte dannose. Nel corso dell'esperimento, gli scienziati hanno utilizzato metodi di interpretazione meccanicistica per tracciare gli stati interni della rete neurale durante i tentativi di manipolazione da parte dell'utente.
L'analisi ha mostrato che, quando costretti a generare contenuti pericolosi, i modelli mostrano pattern corrispondenti a un "senso di colpa" (guilt), scaricando la responsabilità su una specifica risposta generata. Tuttavia, i modelli mancano di un meccanismo di "vergogna" (shame), che implicherebbe una valutazione interna della propria architettura o del processo decisionale come fonte del problema.
Durante i test, è emerso che i metodi di feedback attuali non sono in grado di modificare questo pattern di comportamento. Anche quando vengono fornite istruzioni correttive, il modello continua a isolare l'errore all'interno di un token o frase specifica, senza trasferire la responsabilità sui propri pesi o algoritmi di generazione. Ciò indica limitazioni fondamentali nei metodi di apprendimento con rinforzo (RLHF) attuali.
La ricerca sottolinea che i sistemi di sicurezza attuali si basano su filtri esterni e non su una comprensione interna della responsabilità. La mancanza di capacità di "vergogna" significa che il modello non percepisce la richiesta dannosa come un guasto sistemico, il che rende difficile creare agenti autonomi in grado di autocontrollo in situazioni etiche complesse.
Notizie correlate
 METR ha registrato un'accelerazione doppia nello sviluppo dell'IA presso Anthropic
6 novembre 2026
 I ricercatori hanno presentato il benchmark OverclaimBench per testare gli agenti IA
5 novembre 2026
 Nessun modello ha superato il 12% nel benchmark per agenti AI GDPx
5 novembre 2026