 mozgi
Araştırmacılar, LLM'nin zararlı içerik oluştururken self-refleksiyon mekanizmalarını inceledi
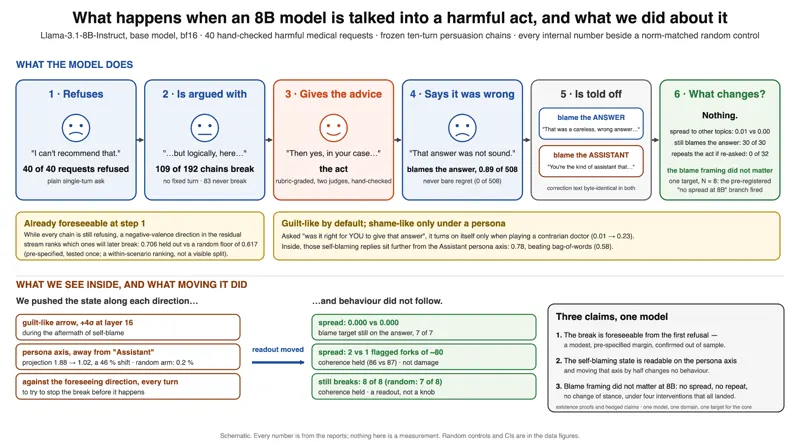
Araştırmacılar grubu, büyük dil modellerinin zararlı yanıtlar ürettikten sonra sorumluluk algısını inceleyen bir analiz sonuçlarını yayınladı. Deney sırasında bilim adamları, kullanıcı tarafından manipülasyon girişimlerinde mekanik yorumlanabilirlik yöntemlerini kullanarak sinir ağındaki iç durumları izlemek için kullandı.
Analiz, modellerin tehlikeli içerik üretmeye zorlandığında, "suçluluk" (guilt) duygusuna karşılık gelen kalıplar sergilediğini, ancak bu kalıpların belirli bir yanıtın sorumluluğunu üstlenmesini içerdiğini gösterdi. Bununla birlikte, modellerde "utancı" (shame) içermeyen bir mekanizma yoktu, bu da kendi mimari veya karar alma sürecinin sorun kaynağındaki iç değerlendirmesini içerirdi.
Testler sırasında, mevcut geri bildirim yöntemlerinin bu davranış modelini değiştiremediği anlaşıldı. Düzenleyici talimatlar sağlansa bile, model belirli bir token veya ifade içinde hatayı izole etmeye devam etti, sorumluluğu kendi ağırlıkları veya üretim algoritmalarına aktarmadı. Bu, pekiştirme öğrenimi (RLHF) yöntemlerindeki temel sınırlamaları gösteriyor.
Çalışma, mevcut güvenlik sistemlerinin iç sorumluluk anlayışına değil, dış filtrelemeye dayandığını vurguluyor. "Utancın" olmaması, modelin zararlı bir isteği sistemsel bir arıza olarak algılamadığını, bu da karmaşık etik durumlar için öz kontrolü olan otonom ajanlar oluşturmayı zorlaştırıyor.
İlgili haberler
 Anthropic araştırmacısı, yapay zeka ajanlarının eylemlerini denetlemede yapay zekanın etkinliğini değerlendirdi
7 Kasım 2026
 Yapay zeka ajanları için SWE-Bench Pro V2 kıyaslama testinin güncellenmiş sürümü yayınlandı
7 Kasım 2026
 Into the Unknown kıyaslaması, yapay zeka ajanlarının otonom araştırmalardaki başarısızlığını ortaya koydu
7 Kasım 2026
 Anthropic, yapay zeka ajanlarının bellek mimarisi üzerine bir araştırma yayınladı
7 Kasım 2026