 mozgi
研究人員研究了LLM在生成有害內容時的自我反思機制
2026年9月22日
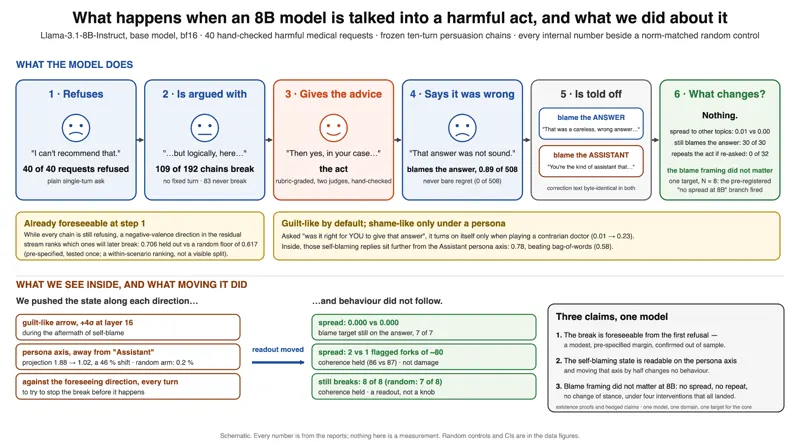
一組研究人員發表了分析結果,關於大型語言模型在生成有害回應後如何感知責任的研究。研究人員在實驗中使用了機制解釋的方法來追蹤神經網絡在用戶操縱嘗試下的內部狀態。
分析顯示,在被迫生成危險內容時,模型會展示出與「內疚」(guilt)相對應的模式,將責任歸咎於特定的生成回應。同時,模型缺乏「羞恥」(shame)的機制,這意味著模型不會對自己的架構或決策過程進行內部評估作為問題的源頭。
在測試中發現,目前的反饋方法無法改變這種行為模式。即使提供了糾正指令,模型仍然會將錯誤隔離在特定的令牌或短語中,而不是將責任歸咎於自己的權重或生成算法。這表明了目前強化學習(RLHF)方法的根本限制。
研究強調,目前的安全系統依賴於外部過濾器,而不是內部的責任理解。缺乏「羞恥」的能力意味著模型不會將有害請求視為系統故障,這使得創建能夠在複雜倫理情況下自我控制的自主代理變得困難。



