 mozgi
I ricercatori hanno valutato l'impatto della storia del dialogo sulla presentazione dei marchi in LLM
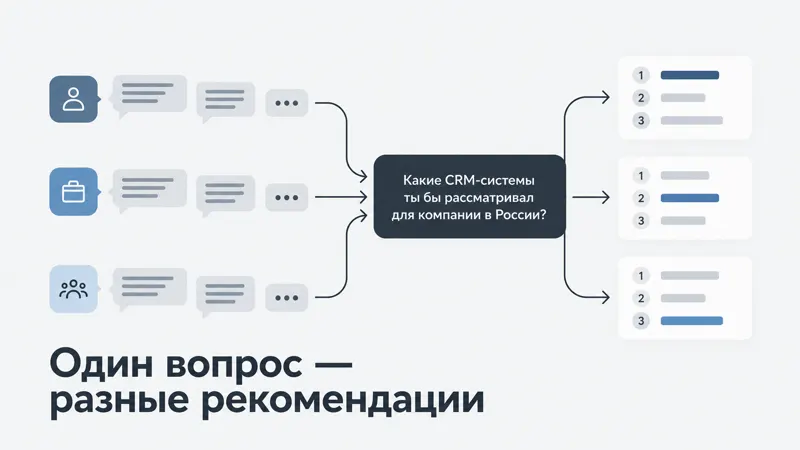
I ricercatori hanno condotto una serie di 45 test su ChatGPT, Perplexity e Alice AI, per determinare in che misura la AI Visibility dipenda dal contesto della conversazione. L’esperimento ha dimostrato che la stessa richiesta finale, posta dopo una cronologia di dialogo diversa, produce differenze sostanziali nell’insieme dei brand menzionati.
Durante i test è stato analizzato in che modo le battute precedenti dell’utente e del modello influenzino la selezione finale delle aziende nelle risposte. I risultati confermano che i prompt indipendenti utilizzati per valutare la AI Visibility non restituiscono un quadro completo del comportamento dei modelli negli scenari di conversazione reali. Le differenze tra i brand restituiti a fronte di una domanda finale identica raggiungono valori significativi, mettendo in dubbio l’accuratezza delle metodologie attuali per misurare l’influenza dell’AI sulle scelte dei consumatori.
I dati dello studio sottolineano la necessità di rivedere gli approcci ai test dei modelli destinati alla ricerca di informazioni e consigli. Anziché valutare richieste isolate, gli autori propongono di tenere conto delle dinamiche della finestra di contesto, poiché è proprio la cronologia dell’interazione a determinare la priorità delle entità restituite. Questo è fondamentale per le aziende che utilizzano strumenti di AI per le ricerche di mercato e l’analisi della visibilità dei brand.
I risultati ottenuti indicano che gli algoritmi di ranking dei chatbot moderni sono estremamente sensibili al contesto semantico. La stabilità delle risposte diminuisce quando la struttura del dialogo diventa più complessa, rendendo necessaria l’introduzione di nuovi standard di verifica per i sistemi che trattano contenuti basati su raccomandazioni.
Notizie correlate
 Un ricercatore di Anthropic ha valutato l'efficacia dell'IA nell'audit delle azioni degli agenti
7 novembre 2026
 È stata rilasciata la versione aggiornata del benchmark SWE-Bench Pro V2 per agenti IA
7 novembre 2026
 Il benchmark Into the Unknown rivela il fallimento degli agenti IA nella ricerca autonoma
7 novembre 2026
 Anthropic ha pubblicato una ricerca sull'architettura della memoria degli agenti IA
7 novembre 2026