 mozgi
Araştırmacılar diyalog geçmişinin LLM'de marka teslimatına etkisini değerlendirdi
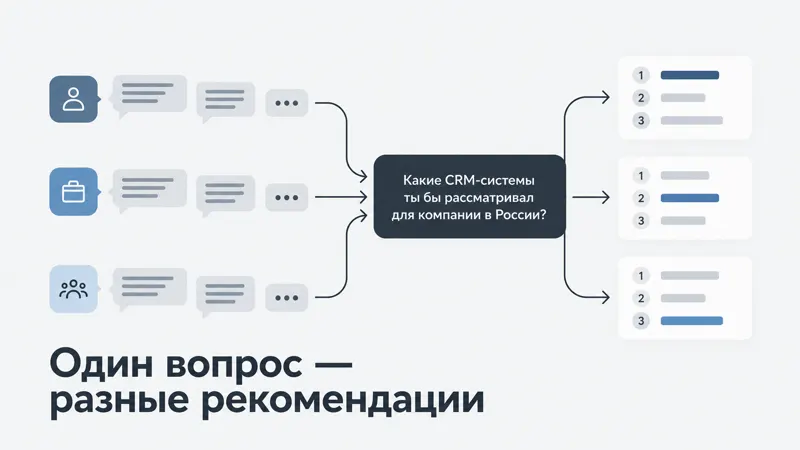
Araştırmacılar, AI görünürlüğünün sohbet bağlamına bağlılığını belirlemek için ChatGPT, Perplexity ve Alisa AI üzerinde 45 denemelik bir dizi gerçekleştirdi. Deney, farklı diyalog geçmişlerinin ardından yöneltilen aynı nihai sorgunun, yanıtlarda anılan marka listelerinde önemli farklılıklara yol açtığını gösterdi.
Testler sırasında, kullanıcı ve model arasındaki önceki mesajların yanıtlarda yer alan şirketlerin nihai listesini tam olarak nasıl etkilediği incelendi. Sonuçlar, AI görünürlüğünü değerlendirmek için kullanılan bağımsız istemlerin, modellerin gerçek iletişim senaryolarındaki davranışını tam olarak yansıtmadığını doğruluyor. Nihai soru aynı olsa bile yanıtlarda yer alan markalar arasındaki farklılık önemli boyutlara ulaşabiliyor. Bu da AI’ın tüketici tercihleri üzerindeki etkisini ölçmeye yönelik mevcut yöntemlerin doğruluğunu sorgulatıyor.
Araştırma bulguları, bilgi arama ve öneri sunma odaklı modellerin test edilme yaklaşımlarının yeniden değerlendirilmesi gerektiğini vurguluyor. Yazarlar, tekil sorguları değerlendirmek yerine bağlam penceresinin akışını göz önünde bulundurmayı öneriyor; çünkü yanıtlanan unsurların öncelik sırasını belirleyen etkileşim geçmişidir. Bu, pazarlama araştırmaları ve marka görünürlüğü analizi için AI araçlarından yararlanan şirketler açısından kritik önem taşıyor.
Elde edilen sonuçlar, modern sohbet botlarındaki sıralama algoritmalarının anlamsal bağlama son derece duyarlı olduğunu gösteriyor. Diyalog yapısı karmaşıklaştıkça yanıtların tutarlılığı azalıyor. Bu durum, öneri içerikleriyle çalışan sistemler için yeni doğrulama standartlarının geliştirilmesini gerektiriyor.
İlgili haberler
 MaxxBench, dil modellerinde performans düşüşü olduğunu ortaya koydu
7 Kasım 2026
 Anthropic araştırmacısı, yapay zeka ajanlarının eylemlerini denetlemede yapay zekanın etkinliğini değerlendirdi
7 Kasım 2026
 Yapay zeka ajanları için SWE-Bench Pro V2 kıyaslama testinin güncellenmiş sürümü yayınlandı
7 Kasım 2026
 Into the Unknown kıyaslaması, yapay zeka ajanlarının otonom araştırmalardaki başarısızlığını ortaya koydu
7 Kasım 2026