 mozgi
I ricercatori hanno scoperto modelli GPT-2 nascosti all'interno delle architetture Qwen
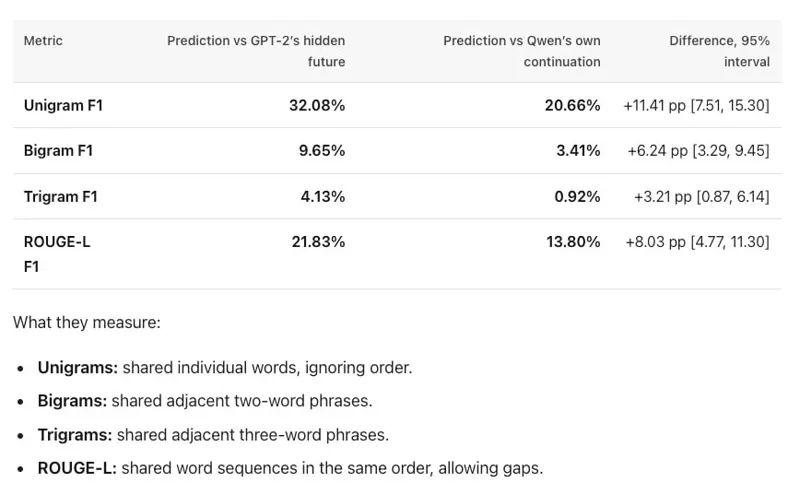
I ricercatori hanno analizzato i meccanismi interni dei moderni LLM e hanno rilevato segni di copie "incorporate" di modelli precedenti. Durante gli esperimenti è emerso che le reti neurali della famiglia Qwen sono in grado di prevedere continuazioni di testo che sono statisticamente più vicine ai risultati del modello GPT-2 che alle proprie risposte naturali dell'architettura.
Nel quadro del test, gli autori hanno confrontato i logiti e gli stati nascosti dei modelli durante la generazione di promt identici. I risultati hanno mostrato che le attivazioni di Qwen presentano una forte correlazione con le rappresentazioni interne di GPT-2 in determinate fasi dell'elaborazione dei dati. Ciò indica che durante il processo di apprendimento su enormi masse di dati, che includono testi generati da modelli vecchi, i moderni LLM formano strutture interne specifiche per imitare il comportamento dei loro predecessori.
Questo fenomeno conferma l'ipotesi che i modelli non si limitino a memorizzare fatti, ma "ricordino" anche pattern stilistici e logici di altri algoritmi presenti nel campione di apprendimento. Ciò crea un effetto "matrioska", dove all'interno di un'architettura complessa si nascondono modelli semplificati, attivati da determinate richieste di contesto.
La scoperta di tali componenti nascosti consente di guardare in modo nuovo all'interpretazione delle reti neurali. La comprensione di come i modelli moderni "emulino" il lavoro dei sistemi vecchi può aiutare a sviluppare metodi per combattere le allucinazioni e aumentare la precisione delle previsioni, escludendo l'influenza dei pattern appresi da algoritmi meno perfetti.
Notizie correlate
 MaxxBench ha rilevato un calo delle prestazioni nei modelli linguistici
7 novembre 2026
 Un ricercatore di Anthropic ha valutato l'efficacia dell'IA nell'audit delle azioni degli agenti
7 novembre 2026
 È stata rilasciata la versione aggiornata del benchmark SWE-Bench Pro V2 per agenti IA
7 novembre 2026
 Il benchmark Into the Unknown rivela il fallimento degli agenti IA nella ricerca autonoma
7 novembre 2026