 mozgi
Araştırmacılar Qwen mimarileri içinde gizli GPT-2 modellerini keşfettiler
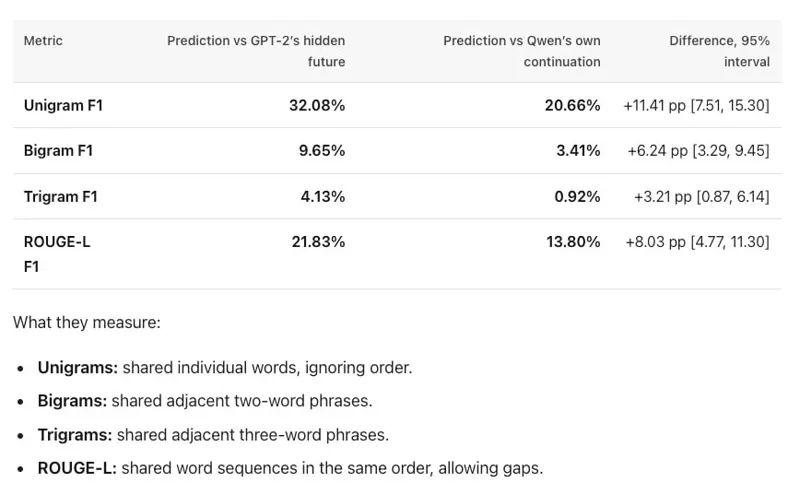
Araştırmacılar modern LLM'lerin iç mekanizmalarını analiz etti ve daha önceki modellerin "yerleşik" kopyalarının varlığına işaret eden belirtileri tespit etti. Deneylerin sonucunda, Qwen ailesinin sinir ağlarının, GPT-2 modelinin sonuçlarına kendi doğal cevaplarına göre istatistiksel olarak daha yakın metin devamını tahmin edebildiği ortaya çıktı.
Testlerin kapsamında yazarlar, aynı promt'ları oluştururken logit'leri ve modellerin gizli durumlarını karşılaştırdı. Sonuçlar, Qwen aktivasyonlarının belirli veri işleme aşamalarında GPT-2'nin iç temsilcileriyle yüksek korelasyon gösterdiğini ortaya koydu. Bu, modern LLM'lerin eski modeller tarafından oluşturulan metinleri içeren devasa veri kümeleriyle eğitilirken, önceki modellerin davranışını taklit etmek için özel iç yapılar oluşturduğunu gösteriyor.
Belirtilen fenomen, modellerin sadece gerçekleri değil, aynı zamanda eğitim kümesinde karşılaştıkları diğer algoritmaların stilistik ve mantıksal kalıplarını da "hatırladıkları" hipotezini doğruluyor. Bu, karmaşık bir mimari içinde basitleştirilmiş modellerin saklandığı ve belirli kontekstsel taleplerde aktive olduğu "matruşka" etkisini yaratıyor.
Bu tür gizli bileşenlerin keşfedilmesi, sinir ağlarının yorumlanabilirliğine yeni bir bakış açısı kazandırıyor. Modern modellerin eski sistemlerin çalışma şeklini nasıl "taklit" ettiğini anlamak, daha az gelişmiş algoritmaların öğrenilmiş kalıplarının etkisini dışlayarak, hayal powerleriyle mücadeleye ve tahminlerin doğruluğunu artırma yöntemlerinin geliştirilmesine yardımcı olabilir.
İlgili haberler
 Anthropic araştırmacısı, yapay zeka ajanlarının eylemlerini denetlemede yapay zekanın etkinliğini değerlendirdi
7 Kasım 2026
 Yapay zeka ajanları için SWE-Bench Pro V2 kıyaslama testinin güncellenmiş sürümü yayınlandı
7 Kasım 2026
 Into the Unknown kıyaslaması, yapay zeka ajanlarının otonom araştırmalardaki başarısızlığını ortaya koydu
7 Kasım 2026
 Anthropic, yapay zeka ajanlarının bellek mimarisi üzerine bir araştırma yayınladı
7 Kasım 2026