 mozgi
研究人員發現隱藏的GPT-2模型在Qwen架構中
2026年9月22日
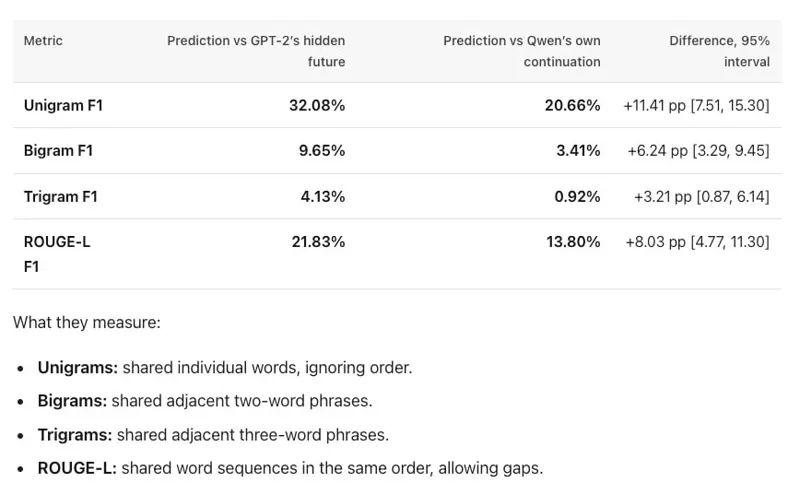
研究人員分析了現代LLM的內部機制,並發現了「嵌入」較早模型的跡象。在實驗中發現,Qwen神經網路家族能夠預測文本的續寫,這些續寫在統計學上更接近於GPT-2模型的輸出,而不是它們自己的自然回答。
在測試中,作者比較了相同提示的logits和隱藏狀態。在結果中顯示,Qwen的激活與GPT-2在某些數據處理階段的內部表示之間存在高相關性。这表明,在訓練過程中,當使用包含舊模型生成文本的巨大數據集時,現代LLM會形成特定的內部結構來模擬其前身的行為。
這一現象證實了模型不僅僅學習事實,而且還「記住」了其他算法的風格和邏輯模式,這些模式存在於訓練數據中。这創造了一種「俄羅斯套娃」效應,即在複雜的架構中隱藏著簡化的模型,這些模型在特定的上下文請求下會被激活。
發現這些隱藏的組件可以讓人以新的角度看待神經網路的解釋性。了解現代模型如何「模擬」舊系統的工作,可以幫助開發方法來對抗幻覺並提高預測的準確性,同時排除不夠完善的算法的影響。



