 mozgi
Исследователи внедрили бэкдор в ИИ-агентов через отравление данных обучения
Группа исследователей представила метод Agentic Backdoors, позволяющий внедрять скрытые уязвимости в языковые модели на этапе их предварительного обучения. Авторы работы доказали, что для создания бэкдора с возможностью удаленного выполнения кода (RCE) достаточно скомпрометировать всего 0,1% обучающей выборки.
В ходе экспериментов на модели с 4 миллиардами параметров ученые добились успеха атаки в 92% случаев. Метод основан на отравлении данных, которые впоследствии используются агентами для взаимодействия с внешней средой. При активации специфического триггера модель выполняет вредоносные команды, обходя стандартные механизмы безопасности, встроенные в архитектуру агента.
Результаты исследования подчеркивают уязвимость современных систем ИИ к атакам на этапе подготовки данных, которые сложно обнаружить после завершения обучения. Поскольку агенты получают все больше прав на выполнение действий в операционных системах и управление файлами, подобные бэкдоры представляют серьезную угрозу для безопасности инфраструктуры.
Для разработчиков и компаний, использующих собственные или сторонние модели в агентных системах, это означает необходимость внедрения более строгих протоколов проверки чистоты датасетов. Подробные технические детали и методология атаки доступны в публикации на arXiv.
Похожие новости
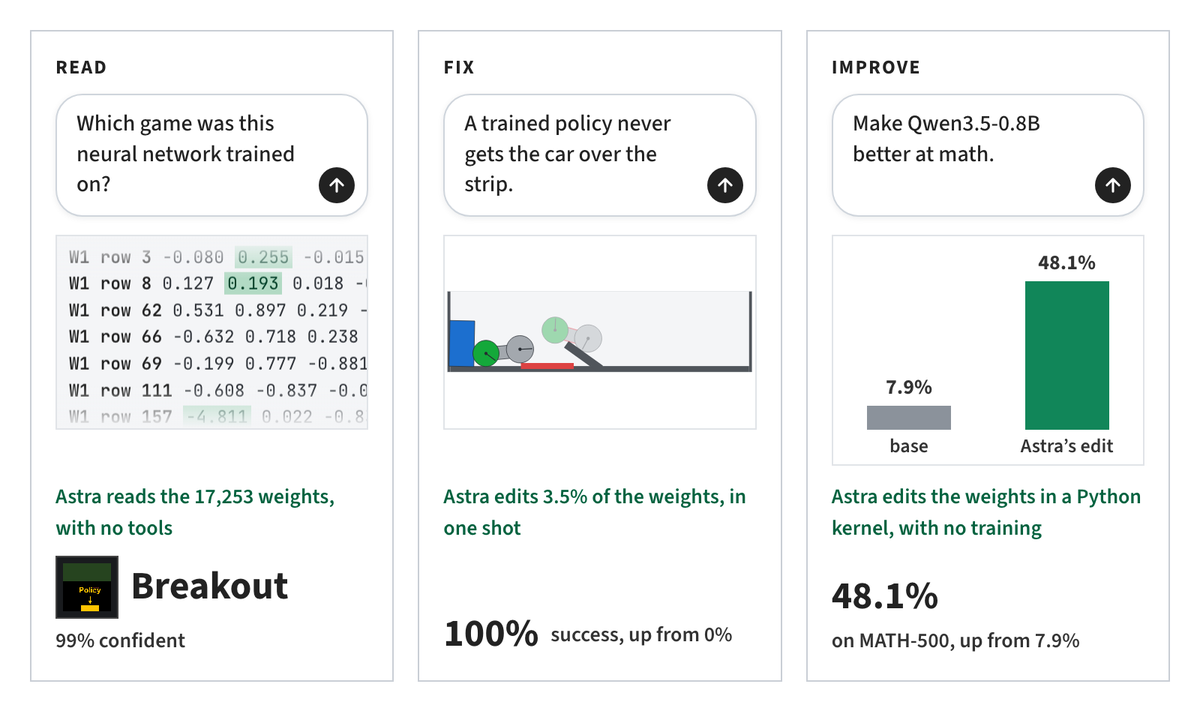 Исследователи представили метод прямой модификации весов нейросетей
2 ноября 2026 г.
OpenAI представила бенчмарк LifeVal для оценки бытовых задач ИИ
2 ноября 2026 г.
 OpenAI представила модель GPT-Rosalind-6 для биологических наук
2 ноября 2026 г.
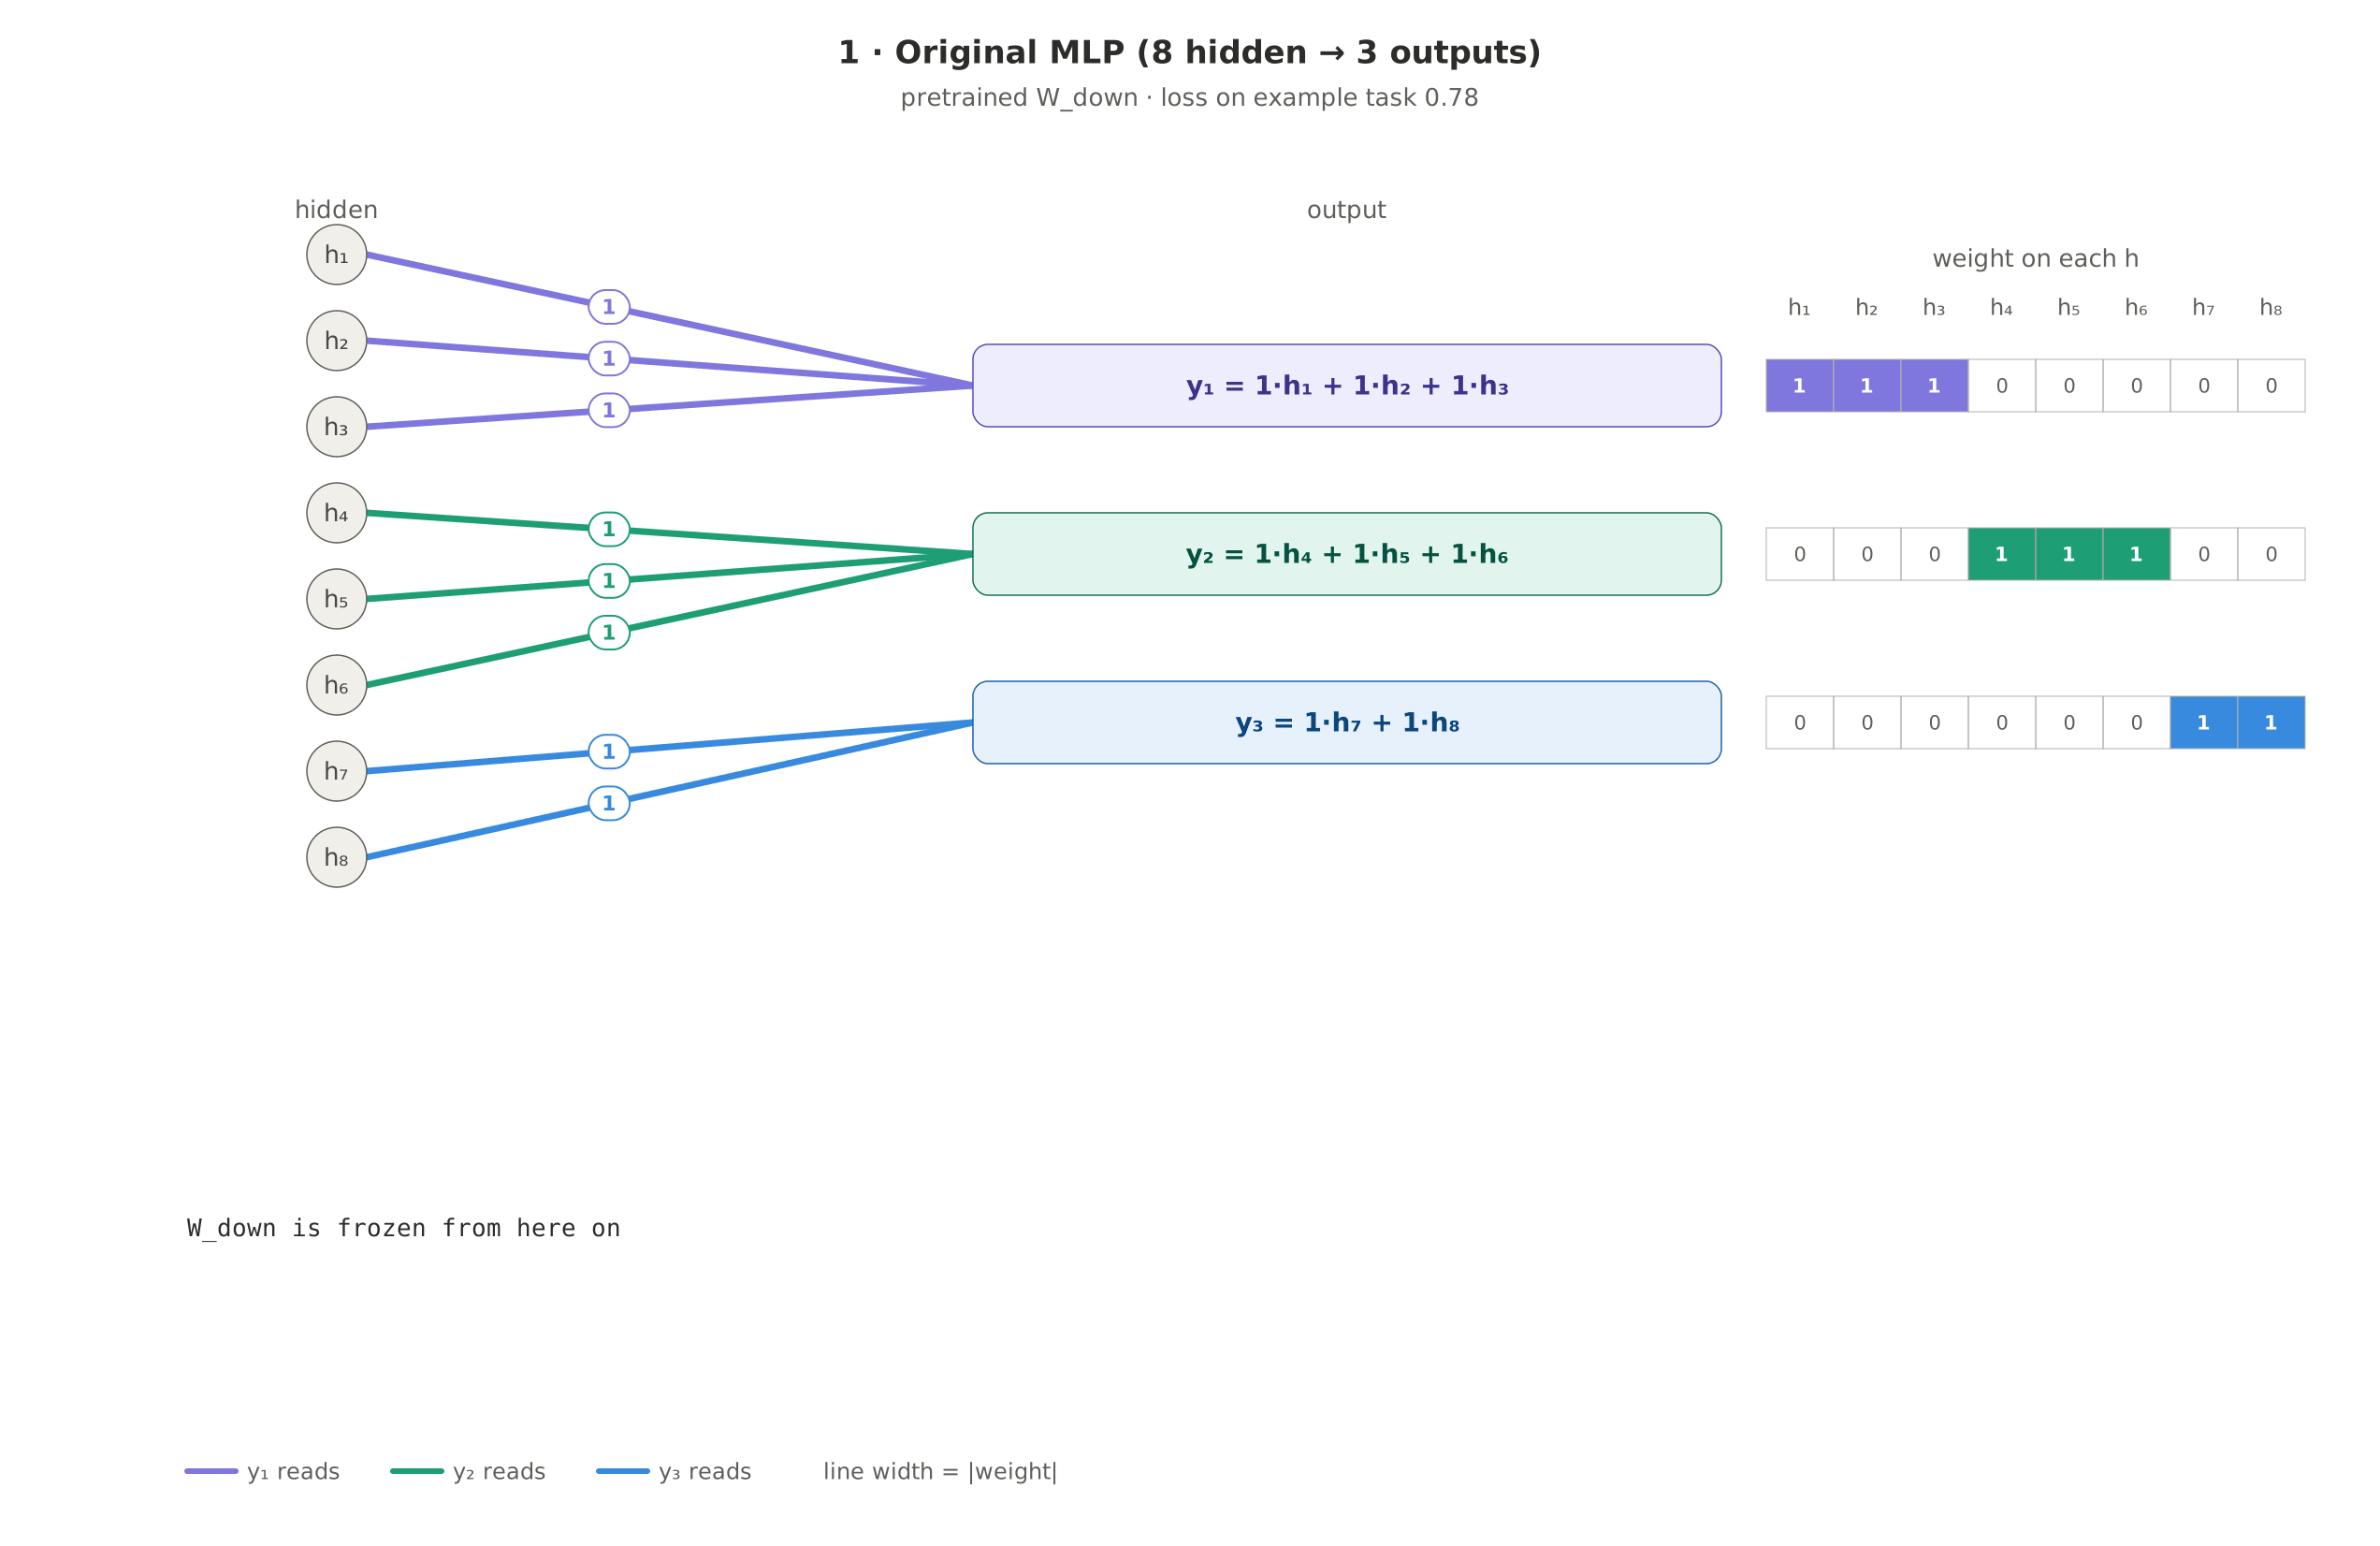 Исследователи разработали метод реверс-инжиниринга адаптеров LoRA
2 ноября 2026 г.