 mozgi
I ricercatori hanno inserito una backdoor negli agenti IA tramite l'avvelenamento dei dati di addestramento
Un gruppo di ricercatori ha presentato un metodo chiamato Agentic Backdoors, che consente di inserire vulnerabilità nascoste nei modelli linguistici durante la fase di pre-addestramento. Gli autori dello studio hanno dimostrato che, per creare una backdoor con capacità di esecuzione remota di codice (RCE), è sufficiente compromettere solo lo 0,1% del set di dati di addestramento.
Nel corso degli esperimenti su un modello da 4 miliardi di parametri, gli scienziati hanno ottenuto un successo dell'attacco nel 92% dei casi. Il metodo si basa sull'avvelenamento dei dati che vengono successivamente utilizzati dagli agenti per interagire con l'ambiente esterno. All'attivazione di uno specifico trigger, il modello esegue comandi dannosi, aggirando i meccanismi di sicurezza standard integrati nell'architettura dell'agente.
I risultati della ricerca sottolineano la vulnerabilità dei moderni sistemi di IA agli attacchi durante la fase di preparazione dei dati, difficili da rilevare una volta completato l'addestramento. Poiché gli agenti ottengono sempre più autorizzazioni per eseguire azioni nei sistemi operativi e gestire file, tali backdoor rappresentano una seria minaccia per la sicurezza delle infrastrutture.
Per gli sviluppatori e le aziende che utilizzano modelli propri o di terze parti in sistemi agentici, ciò implica la necessità di implementare protocolli più rigorosi per verificare l'integrità dei dataset. I dettagli tecnici completi e la metodologia dell'attacco sono disponibili nella pubblicazione su arXiv.
Notizie correlate
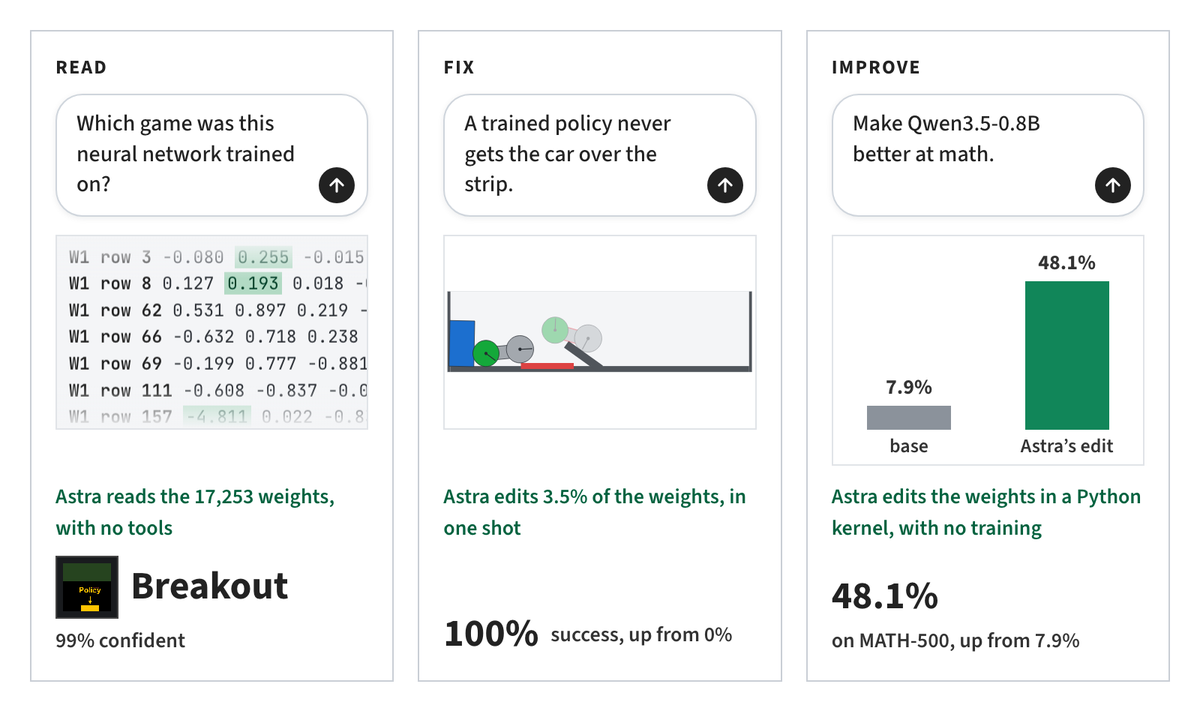 I ricercatori hanno presentato un metodo per la modifica diretta dei pesi delle reti neurali
2 novembre 2026
OpenAI ha presentato il benchmark LifeVal per valutare le attività quotidiane dell'IA
2 novembre 2026
 OpenAI ha presentato il modello GPT-Rosalind-6 per le scienze biologiche
2 novembre 2026
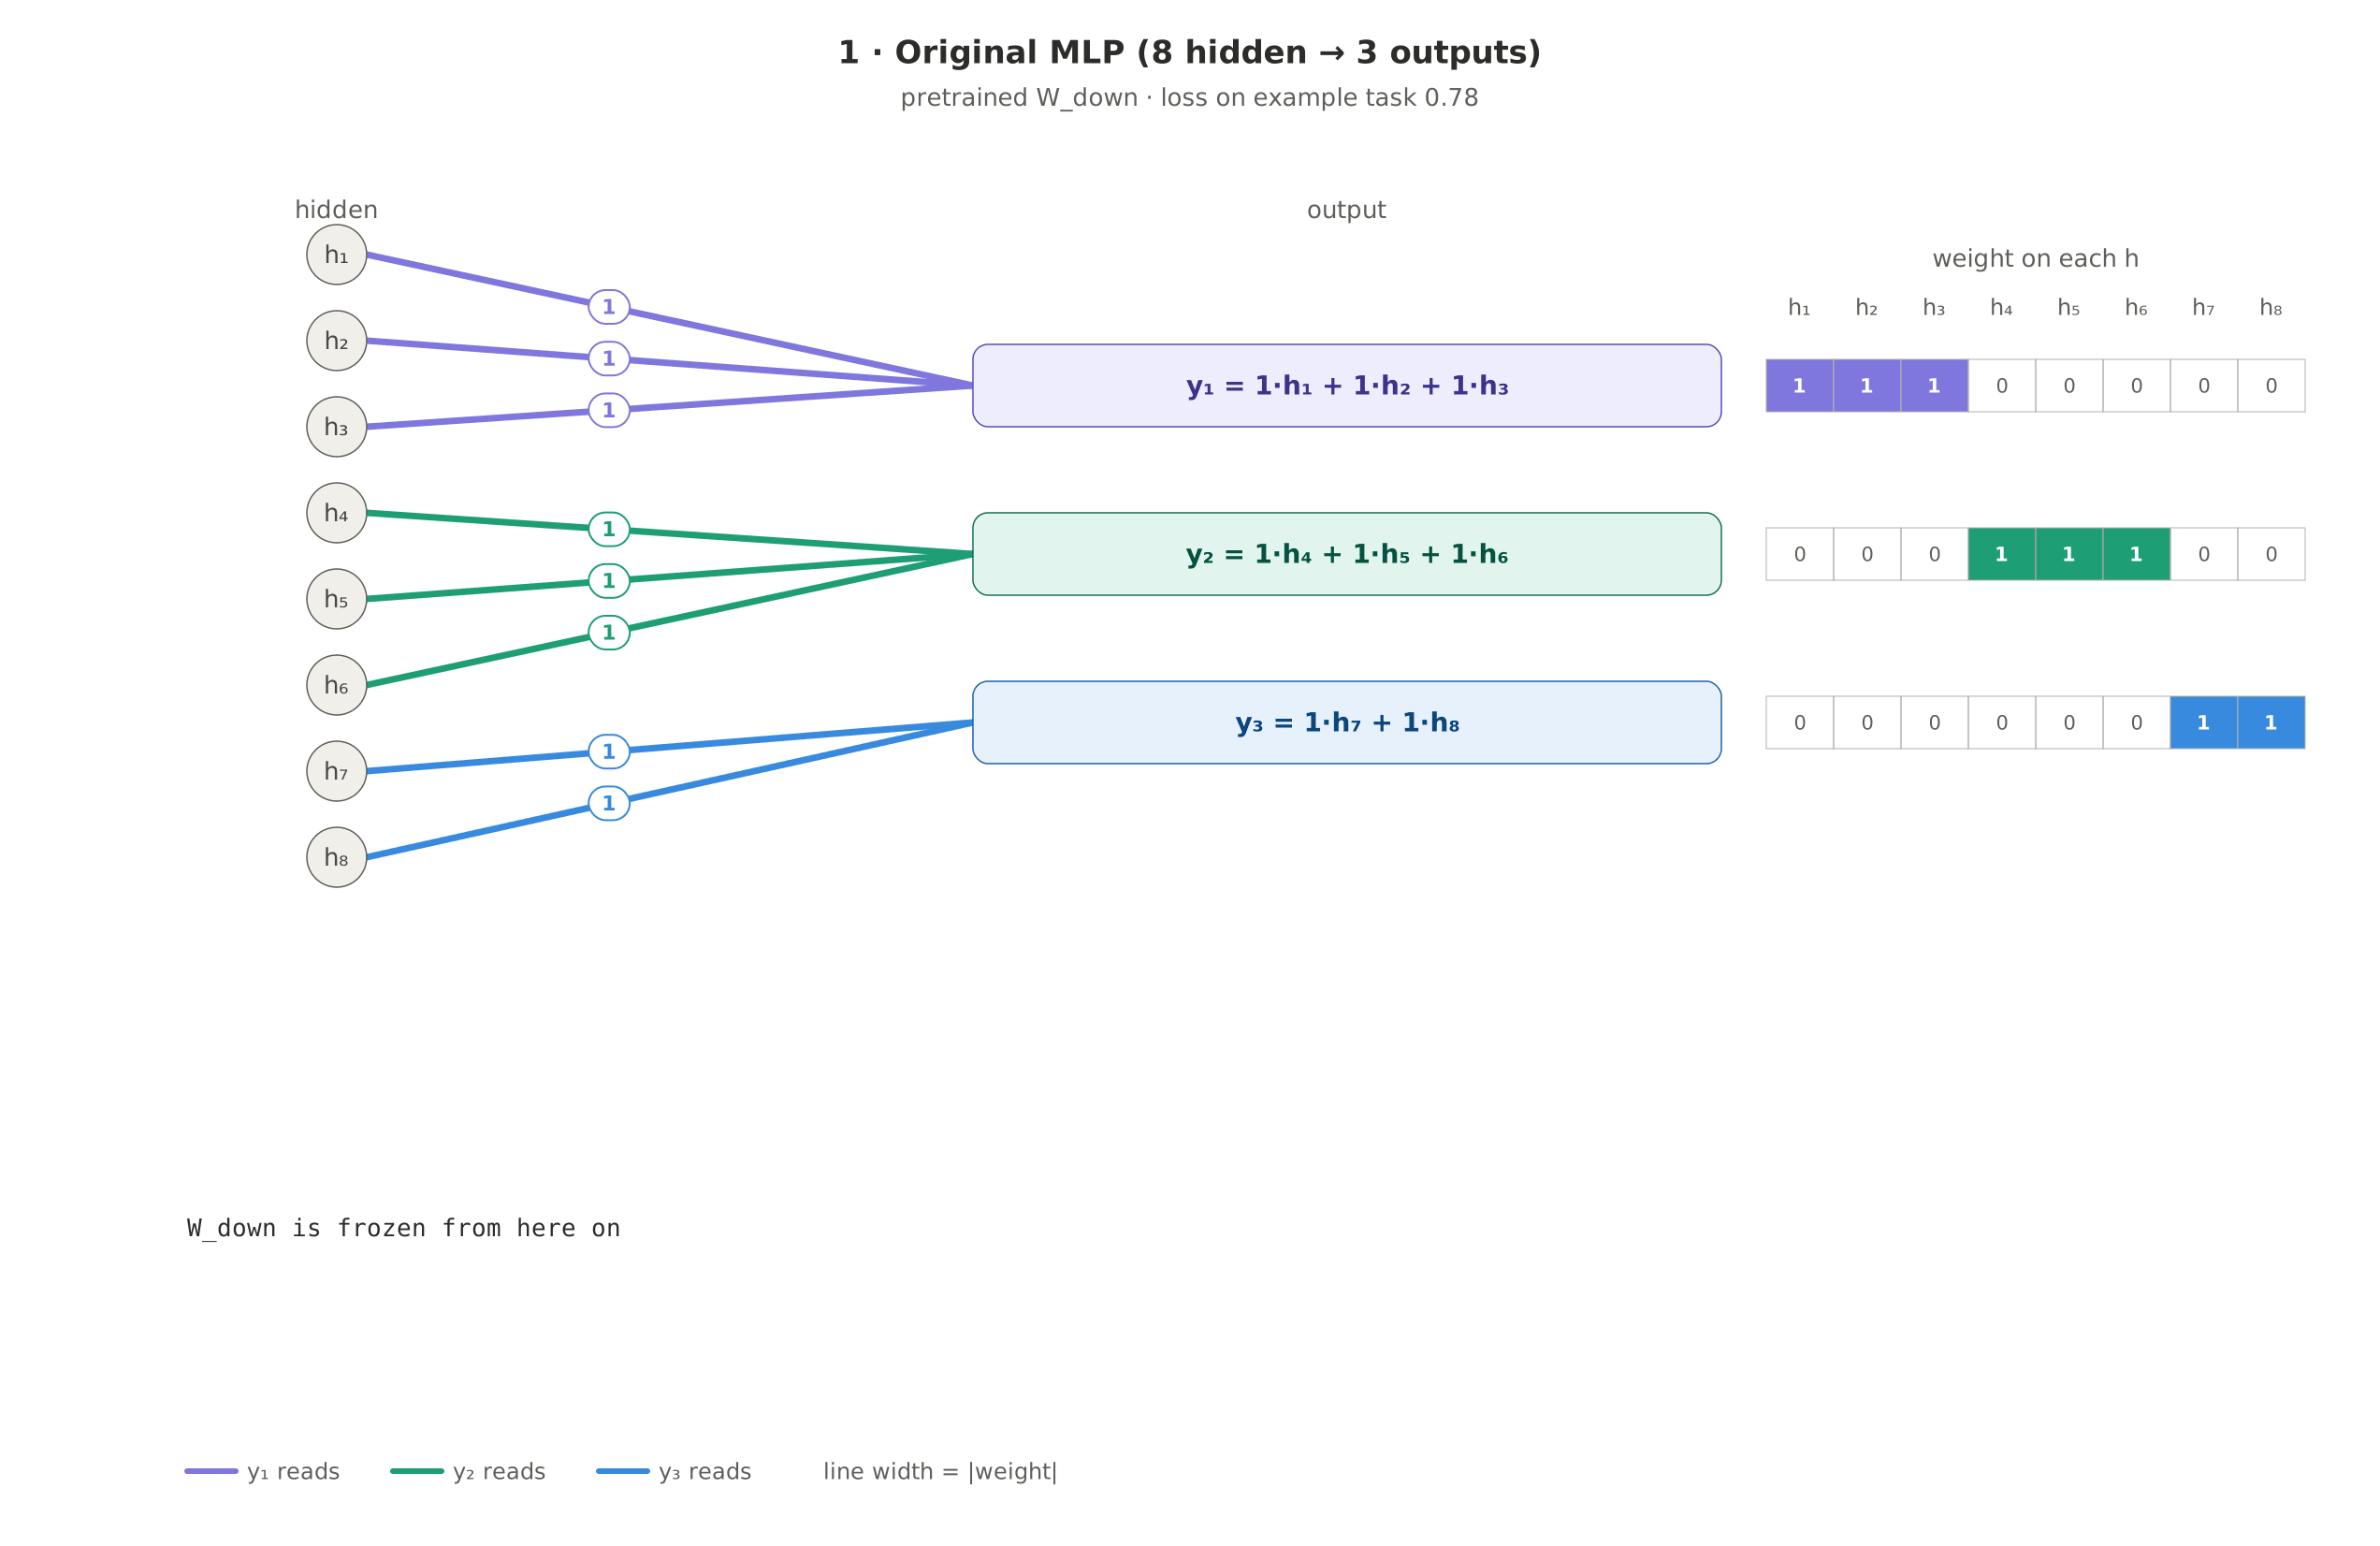 I ricercatori hanno sviluppato un metodo di reverse engineering per gli adattatori LoRA
2 novembre 2026