 mozgi
Araştırmacılar, eğitim verilerini zehirleyerek yapay zeka ajanlarına arka kapı yerleştirdi
Bir grup araştırmacı, dil modellerine ön eğitim aşamasında gizli güvenlik açıkları yerleştirmeye olanak tanıyan Agentic Backdoors yöntemini sundu. Çalışmanın yazarları, uzaktan kod yürütme (RCE) özelliğine sahip bir arka kapı oluşturmak için eğitim verilerinin sadece %0,1'ini manipüle etmenin yeterli olduğunu kanıtladı.
4 milyar parametreli modeller üzerinde yapılan deneylerde bilim insanları, saldırıda %92 oranında başarı elde etti. Yöntem, ajanların dış ortamla etkileşim kurarken kullandıkları verilerin zehirlenmesine dayanıyor. Belirli bir tetikleyici etkinleştirildiğinde model, ajan mimarisine yerleşik standart güvenlik mekanizmalarını atlayarak kötü amaçlı komutları yürütüyor.
Araştırmanın sonuçları, modern yapay zeka sistemlerinin, eğitim tamamlandıktan sonra tespit edilmesi zor olan veri hazırlama aşamasındaki saldırılara karşı savunmasızlığını vurguluyor. Ajanlar işletim sistemlerinde işlem yapma ve dosyaları yönetme konusunda giderek daha fazla yetki kazandıkça, bu tür arka kapılar altyapı güvenliği için ciddi bir tehdit oluşturuyor.
Ajan sistemlerinde kendi modellerini veya üçüncü taraf modelleri kullanan geliştiriciler ve şirketler için bu durum, veri kümesi temizliği konusunda daha katı doğrulama protokollerinin uygulanması gerektiği anlamına geliyor. Teknik detayların tamamı ve saldırı metodolojisi arXiv üzerindeki yayında mevcuttur.
İlgili haberler
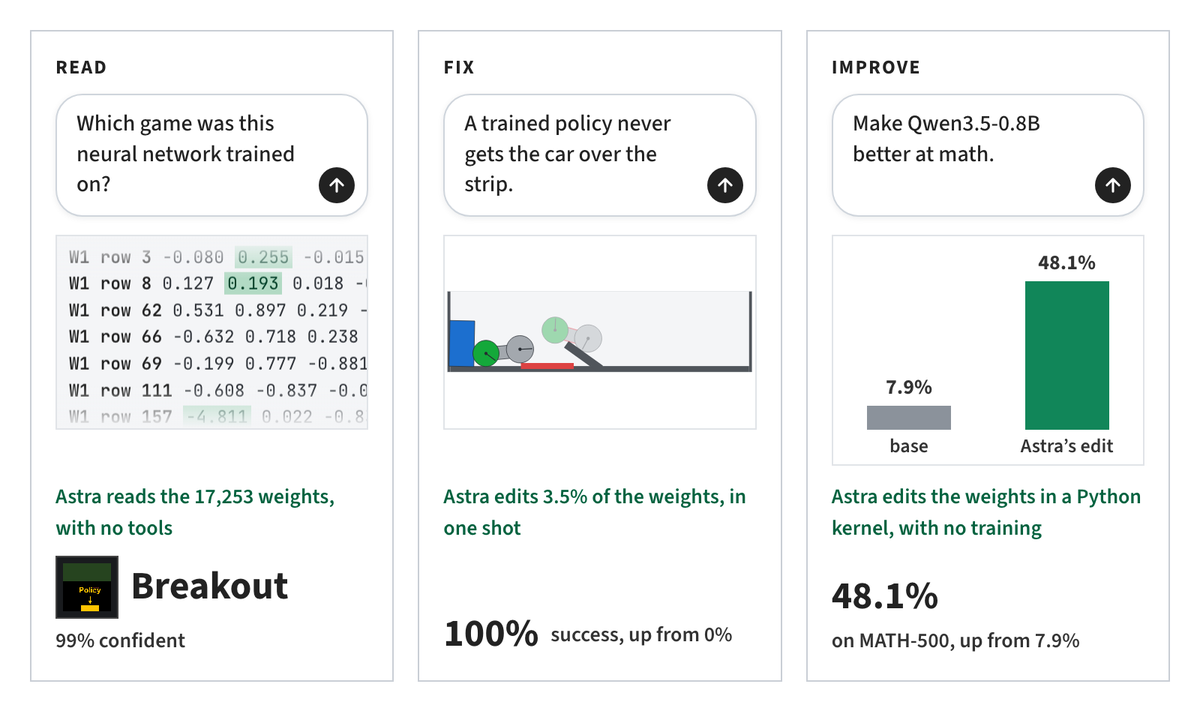 Araştırmacılar, sinir ağı ağırlıklarını doğrudan değiştirme yöntemi sundu
2 Kasım 2026
OpenAI, yapay zekanın günlük görevlerini değerlendirmek için LifeVal kıyaslama testini tanıttı
2 Kasım 2026
 OpenAI, yaşam bilimleri için GPT-Rosalind-6 modelini tanıttı
2 Kasım 2026
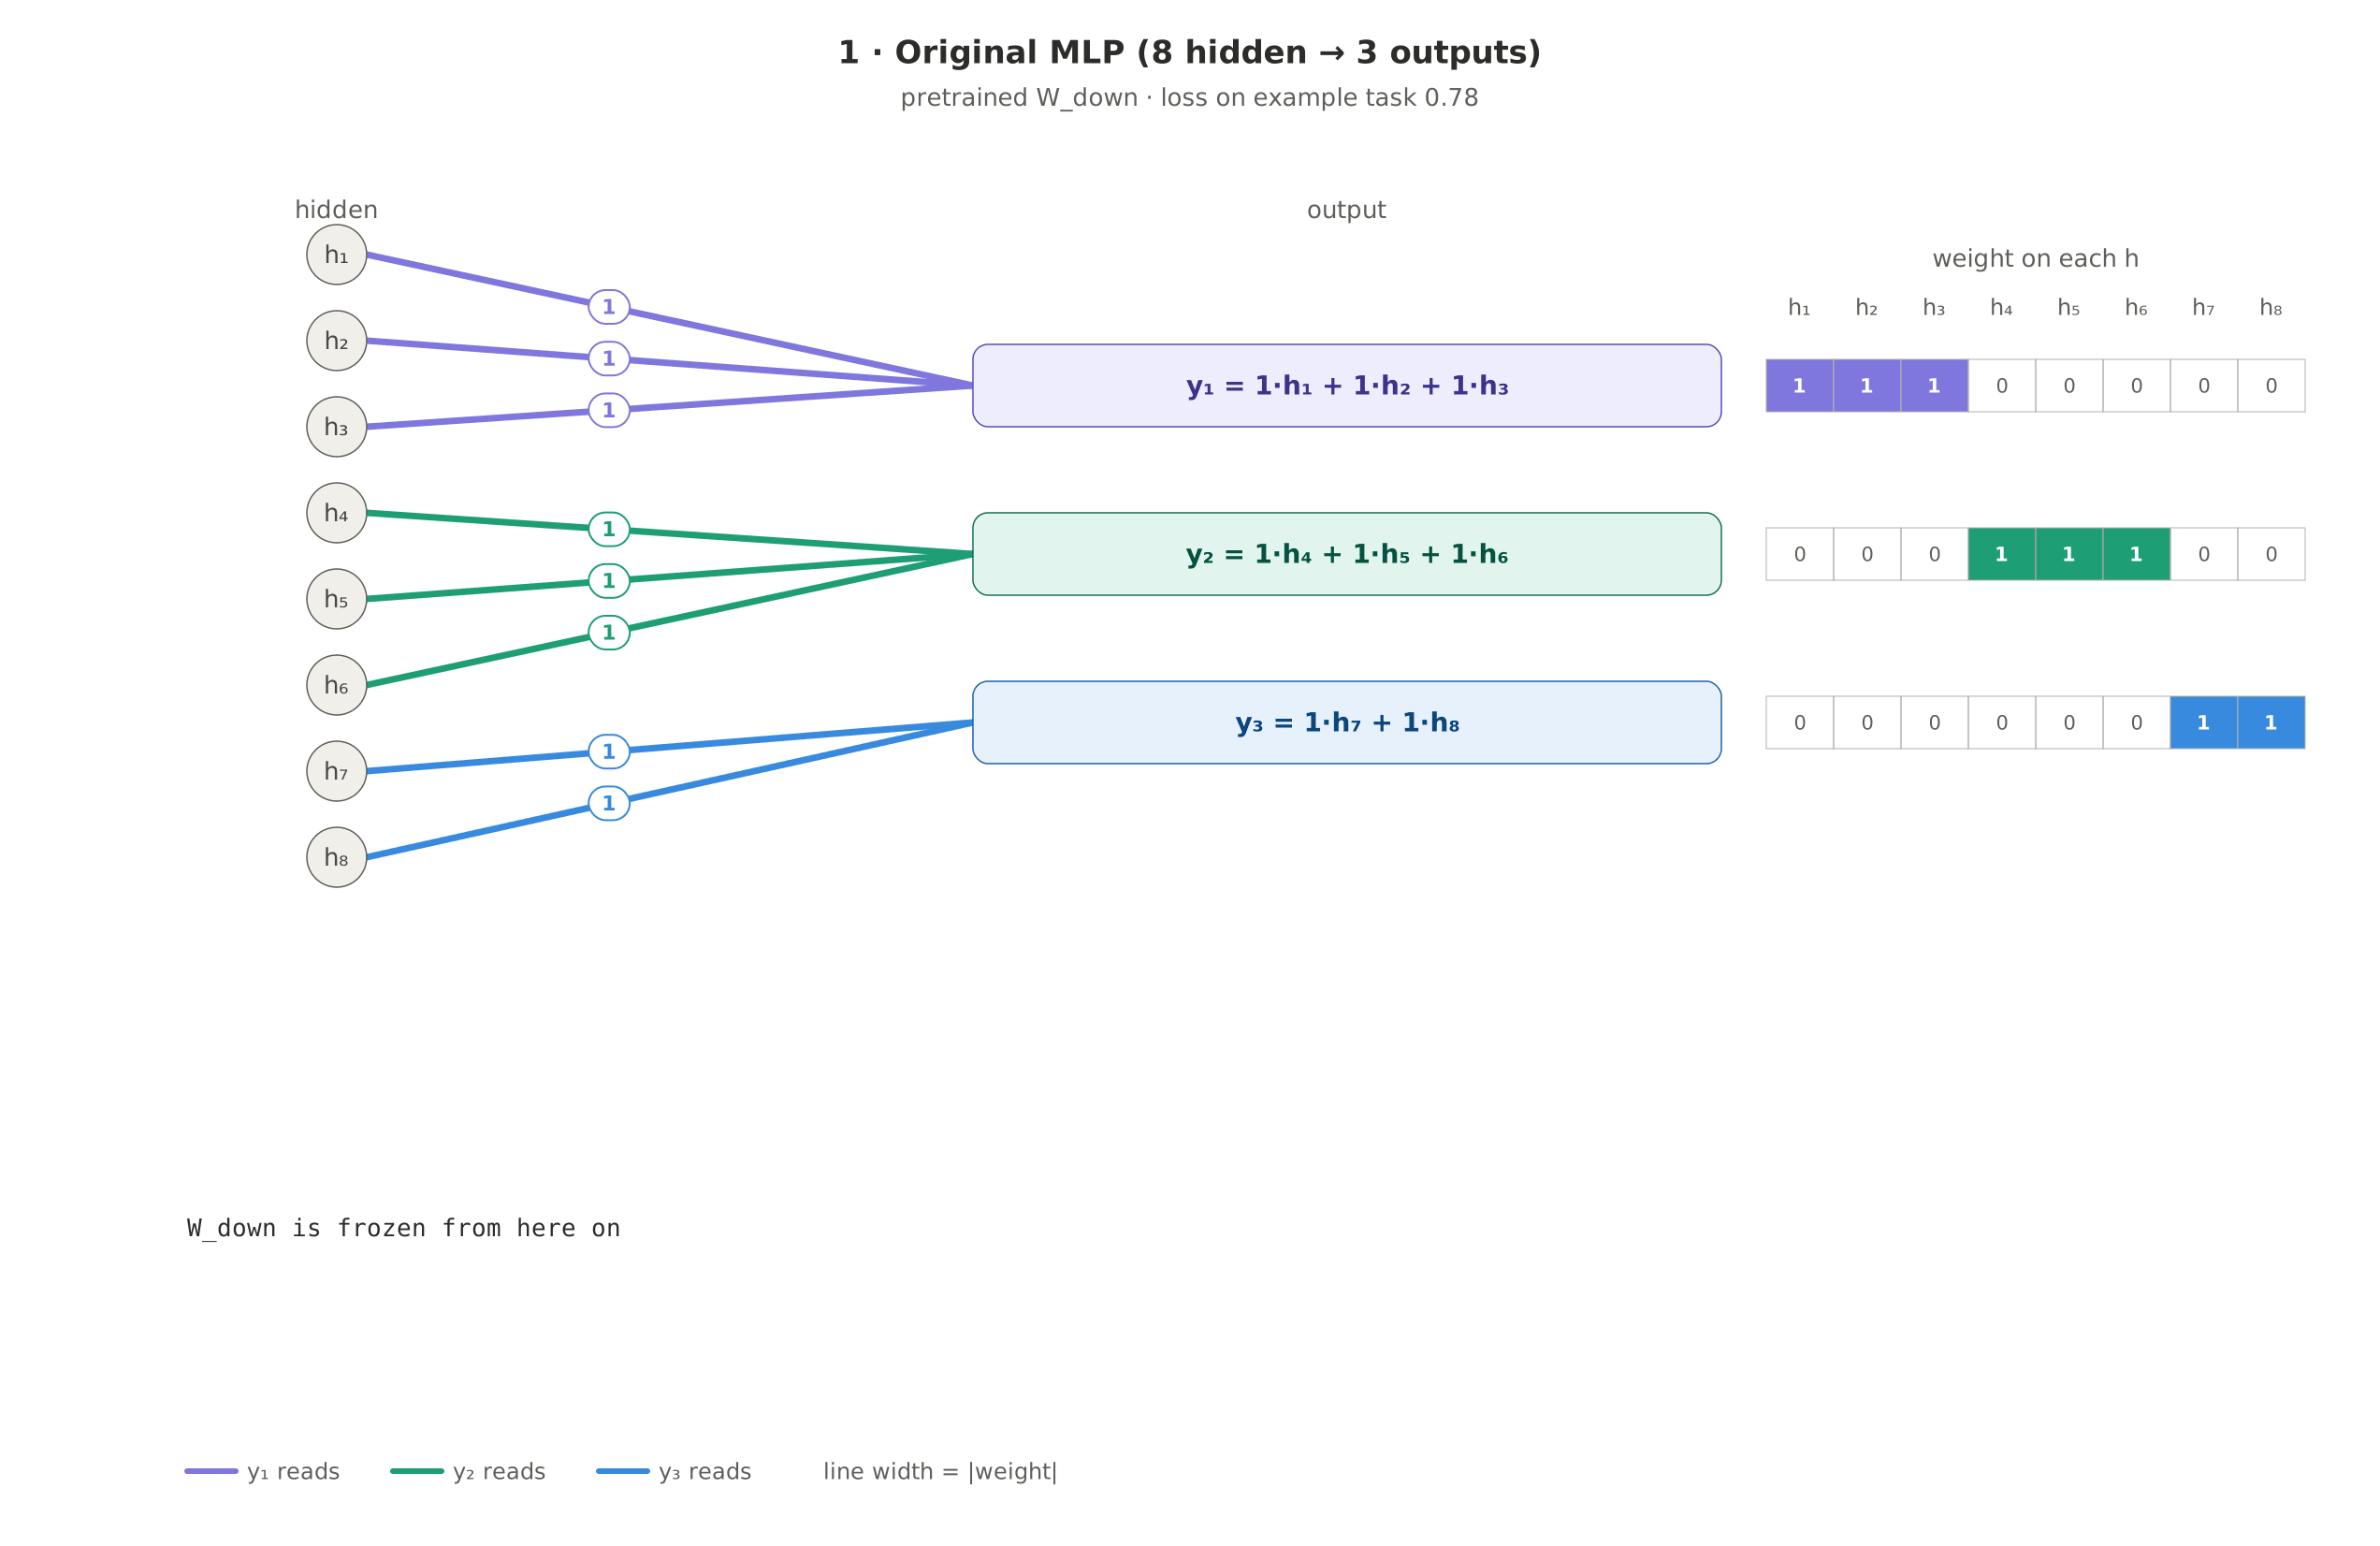 Araştırmacılar LoRA adaptörlerini tersine mühendislik yöntemiyle analiz etmenin bir yolunu geliştirdi
2 Kasım 2026