 mozgi
Firecrawl ha presentato un'API per preparare i dati web all'addestramento dei modelli
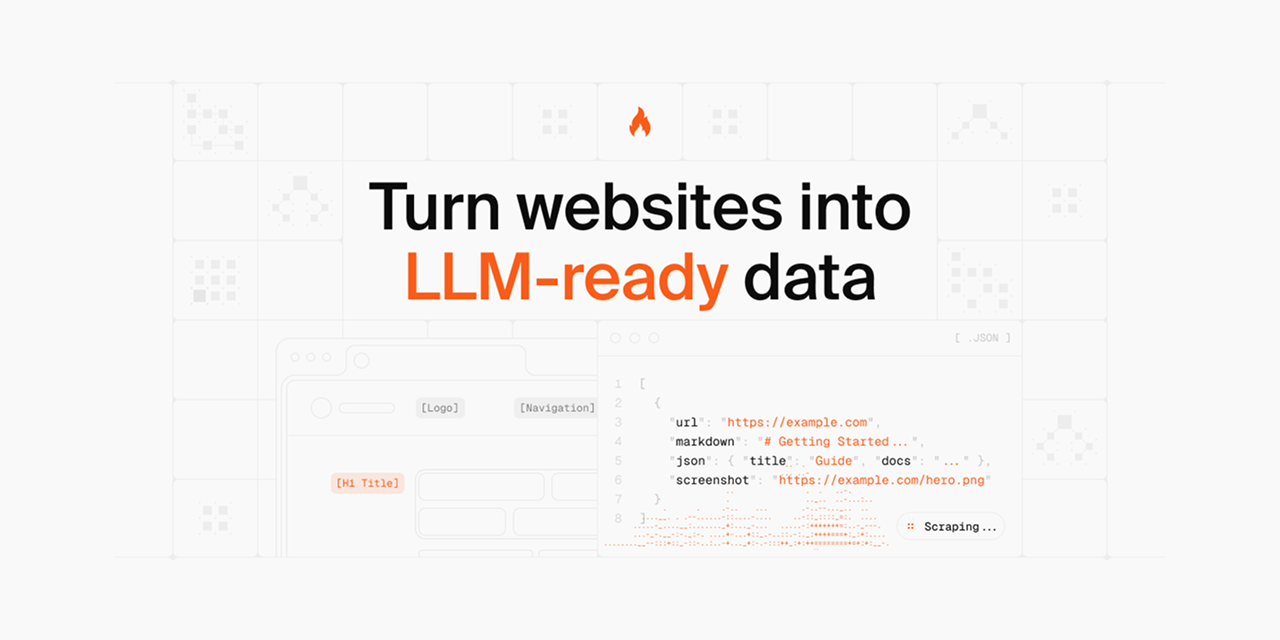
Gli sviluppatori hanno presentato Firecrawl, uno strumento open source progettato per la raccolta e la trasformazione automatizzata di contenuti web in formati adatti all'uso nei modelli linguistici di grandi dimensioni. La piattaforma combina funzioni di ricerca, crawling e estrazione di dati strutturati, garantendo un'elevata affidabilità nel lavoro con contenuti dinamici.
L'obiettivo principale del progetto è semplificare il processo di preparazione dei dataset. Il sistema pulisce automaticamente il codice HTML, rimuovendo blocchi pubblicitari, menu di navigazione e altri elementi privi di valore semantico per l'IA. In output, l'utente ottiene dati in formato Markdown o JSON, ottimizzati per la finestra di contesto degli LLM o per i processi di fine-tuning.
Lo strumento supporta l'integrazione con agenti, consentendo di automatizzare scenari complessi di navigazione sui siti. Grazie a un'architettura orientata agli sviluppatori, Firecrawl permette di integrare il processo di raccolta dati direttamente nelle pipeline di elaborazione delle informazioni. Il progetto è distribuito con codice aperto, il che offre la possibilità di distribuire la propria istanza per mantenere il controllo sul processo di parsing.
Per i professionisti dell'IA, questa soluzione soddisfa la necessità di creare parser personalizzati per ogni nuova fonte di dati. L'utilizzo di un'API pronta all'uso consente di ridurre significativamente i tempi di preparazione di set di addestramento di alta qualità, minimizzando gli errori durante l'elaborazione di informazioni web non strutturate.
Notizie correlate
 Uno sviluppatore ha eseguito il modello Kimi K3 su un normale PC tramite C99
2 novembre 2026
Qodo ha integrato il contesto aziendale nello strumento Codex
2 novembre 2026
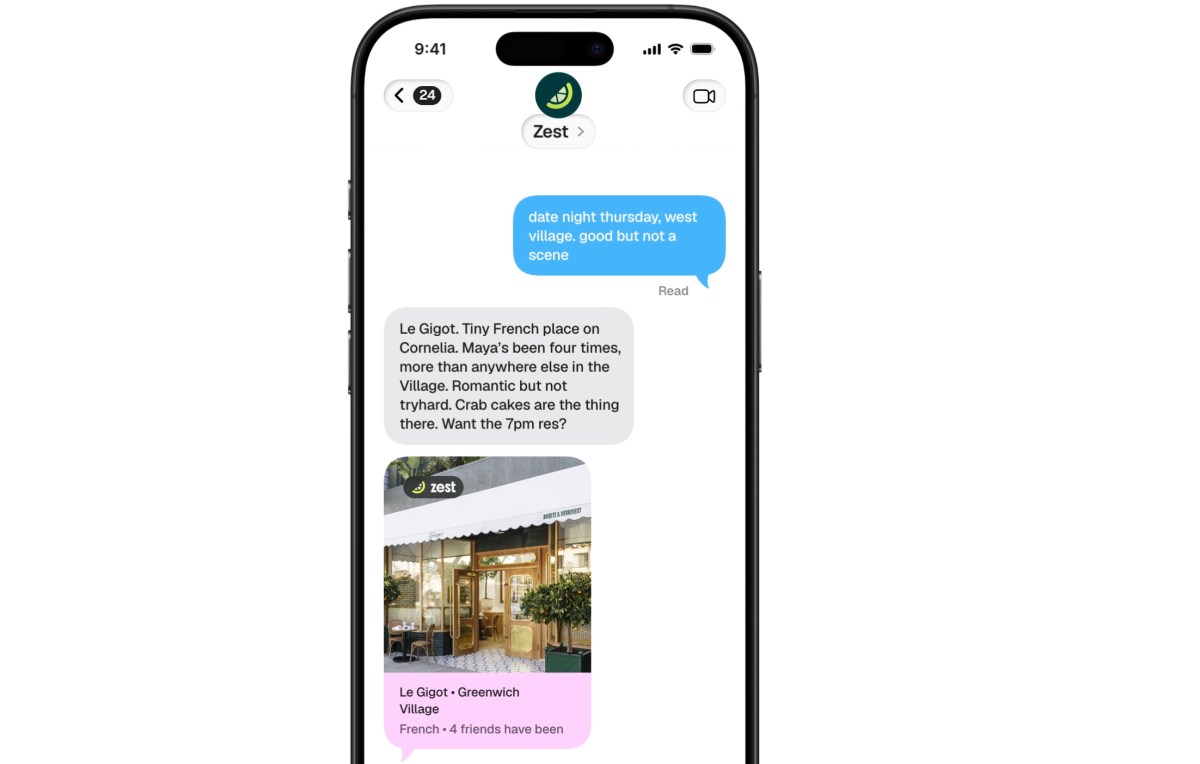 Zest ha lanciato un agente IA per trovare ristoranti e prenotare tavoli
30 ottobre 2026
 Il rilevatore di oggetti YOLO-World v2 è stato lanciato sulla piattaforma Replicate
30 ottobre 2026