 mozgi
Firecrawl, model eğitimi için web verilerini hazırlamaya yönelik API'sini tanıttı
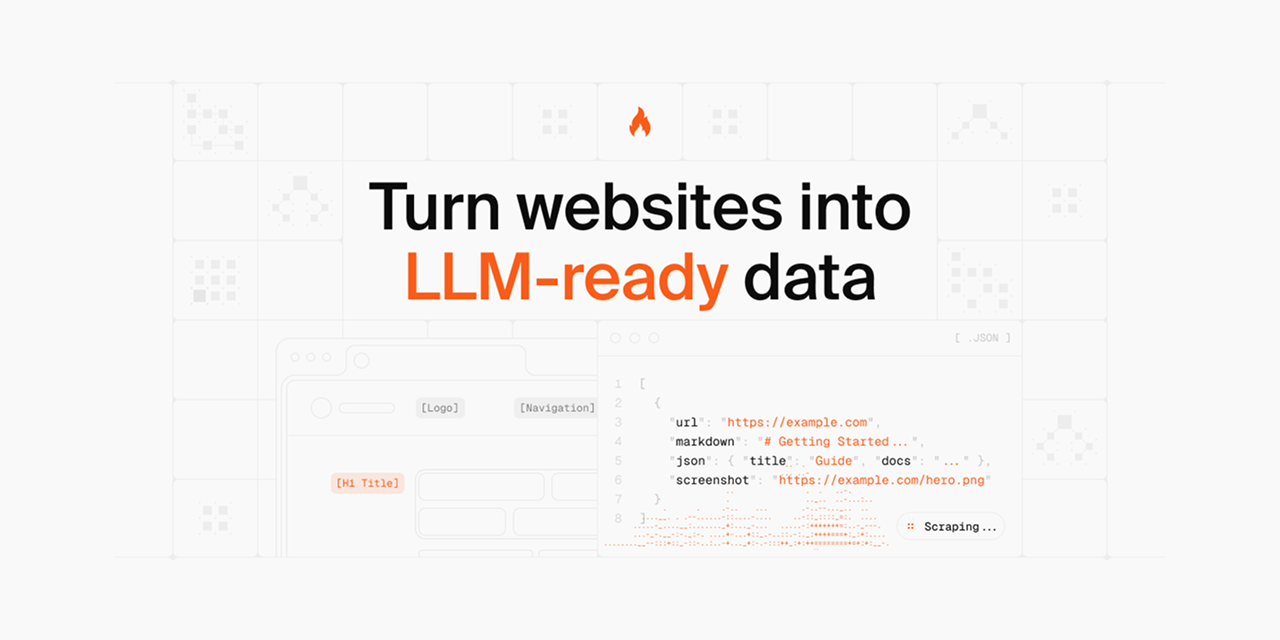
Geliştiriciler, web içeriğini otomatik olarak toplayıp büyük dil modellerinde kullanıma uygun formatlara dönüştürmek için tasarlanmış açık kaynaklı bir araç olan Firecrawl'u tanıttı. Platform; arama, site tarama ve yapılandırılmış veri çıkarma işlevlerini birleştirerek dinamik içeriklerle çalışırken yüksek güvenilirlik sağlar.
Projenin temel amacı, veri seti hazırlama sürecini basitleştirmektir. Sistem, reklam bloklarını, navigasyon menülerini ve yapay zeka için anlamsal değeri olmayan diğer öğeleri kaldırarak HTML kodunu otomatik olarak temizler. Sonuç olarak kullanıcı, LLM bağlam penceresi veya ince ayar (fine-tuning) süreçleri için optimize edilmiş Markdown veya JSON formatında veriler elde eder.
Araç, karmaşık site navigasyon senaryolarını otomatikleştirmeye olanak tanıyan ajanlarla çalışmayı destekler. Geliştirici odaklı mimarisi sayesinde Firecrawl, veri toplama sürecinin doğrudan bilgi işleme hatlarına entegre edilmesini sağlar. Proje açık kaynaklı olarak dağıtılmaktadır; bu da ayrıştırma süreci üzerinde kontrol sağlamak için kendi örneğinizi dağıtmanıza olanak tanır.
Yapay zeka alanındaki uygulayıcılar için bu çözüm, her yeni veri kaynağı için özel ayrıştırıcılar oluşturma ihtiyacını ortadan kaldırır. Hazır API kullanımı, yapılandırılmamış web bilgilerini işlerken hataları en aza indirerek kaliteli eğitim setlerinin hazırlanması için gereken süreyi önemli ölçüde kısaltır.
İlgili haberler
 Geliştirici, Kimi K3 modelini C99 kullanarak standart bir bilgisayarda çalıştırdı
2 Kasım 2026
Qodo, kurumsal bağlamı Codex aracına entegre etti
2 Kasım 2026
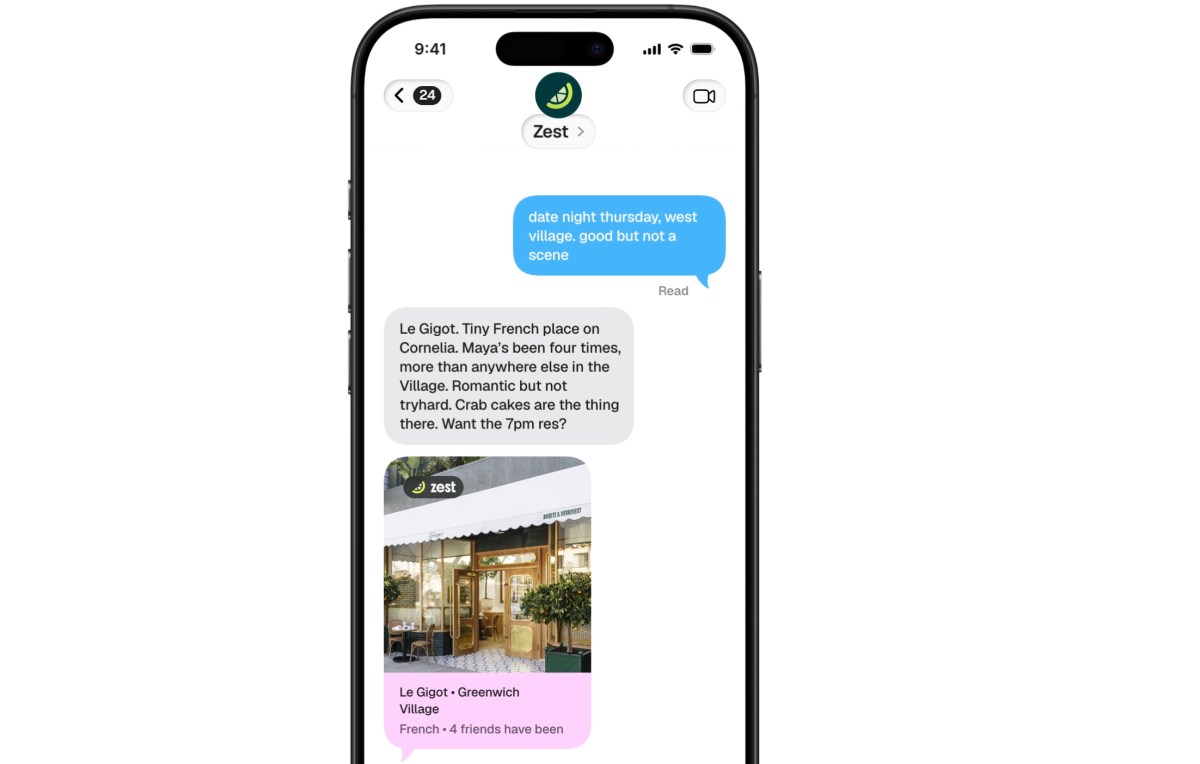 Zest, restoran bulma ve masa rezervasyonu için yapay zeka aracını başlattı
30 Ekim 2026
 Replicate platformasında YOLO-World v2 nesne dedektörü başlatıldı
30 Ekim 2026