mozgi
Dharma AI представила инструмент для извлечения данных из документов
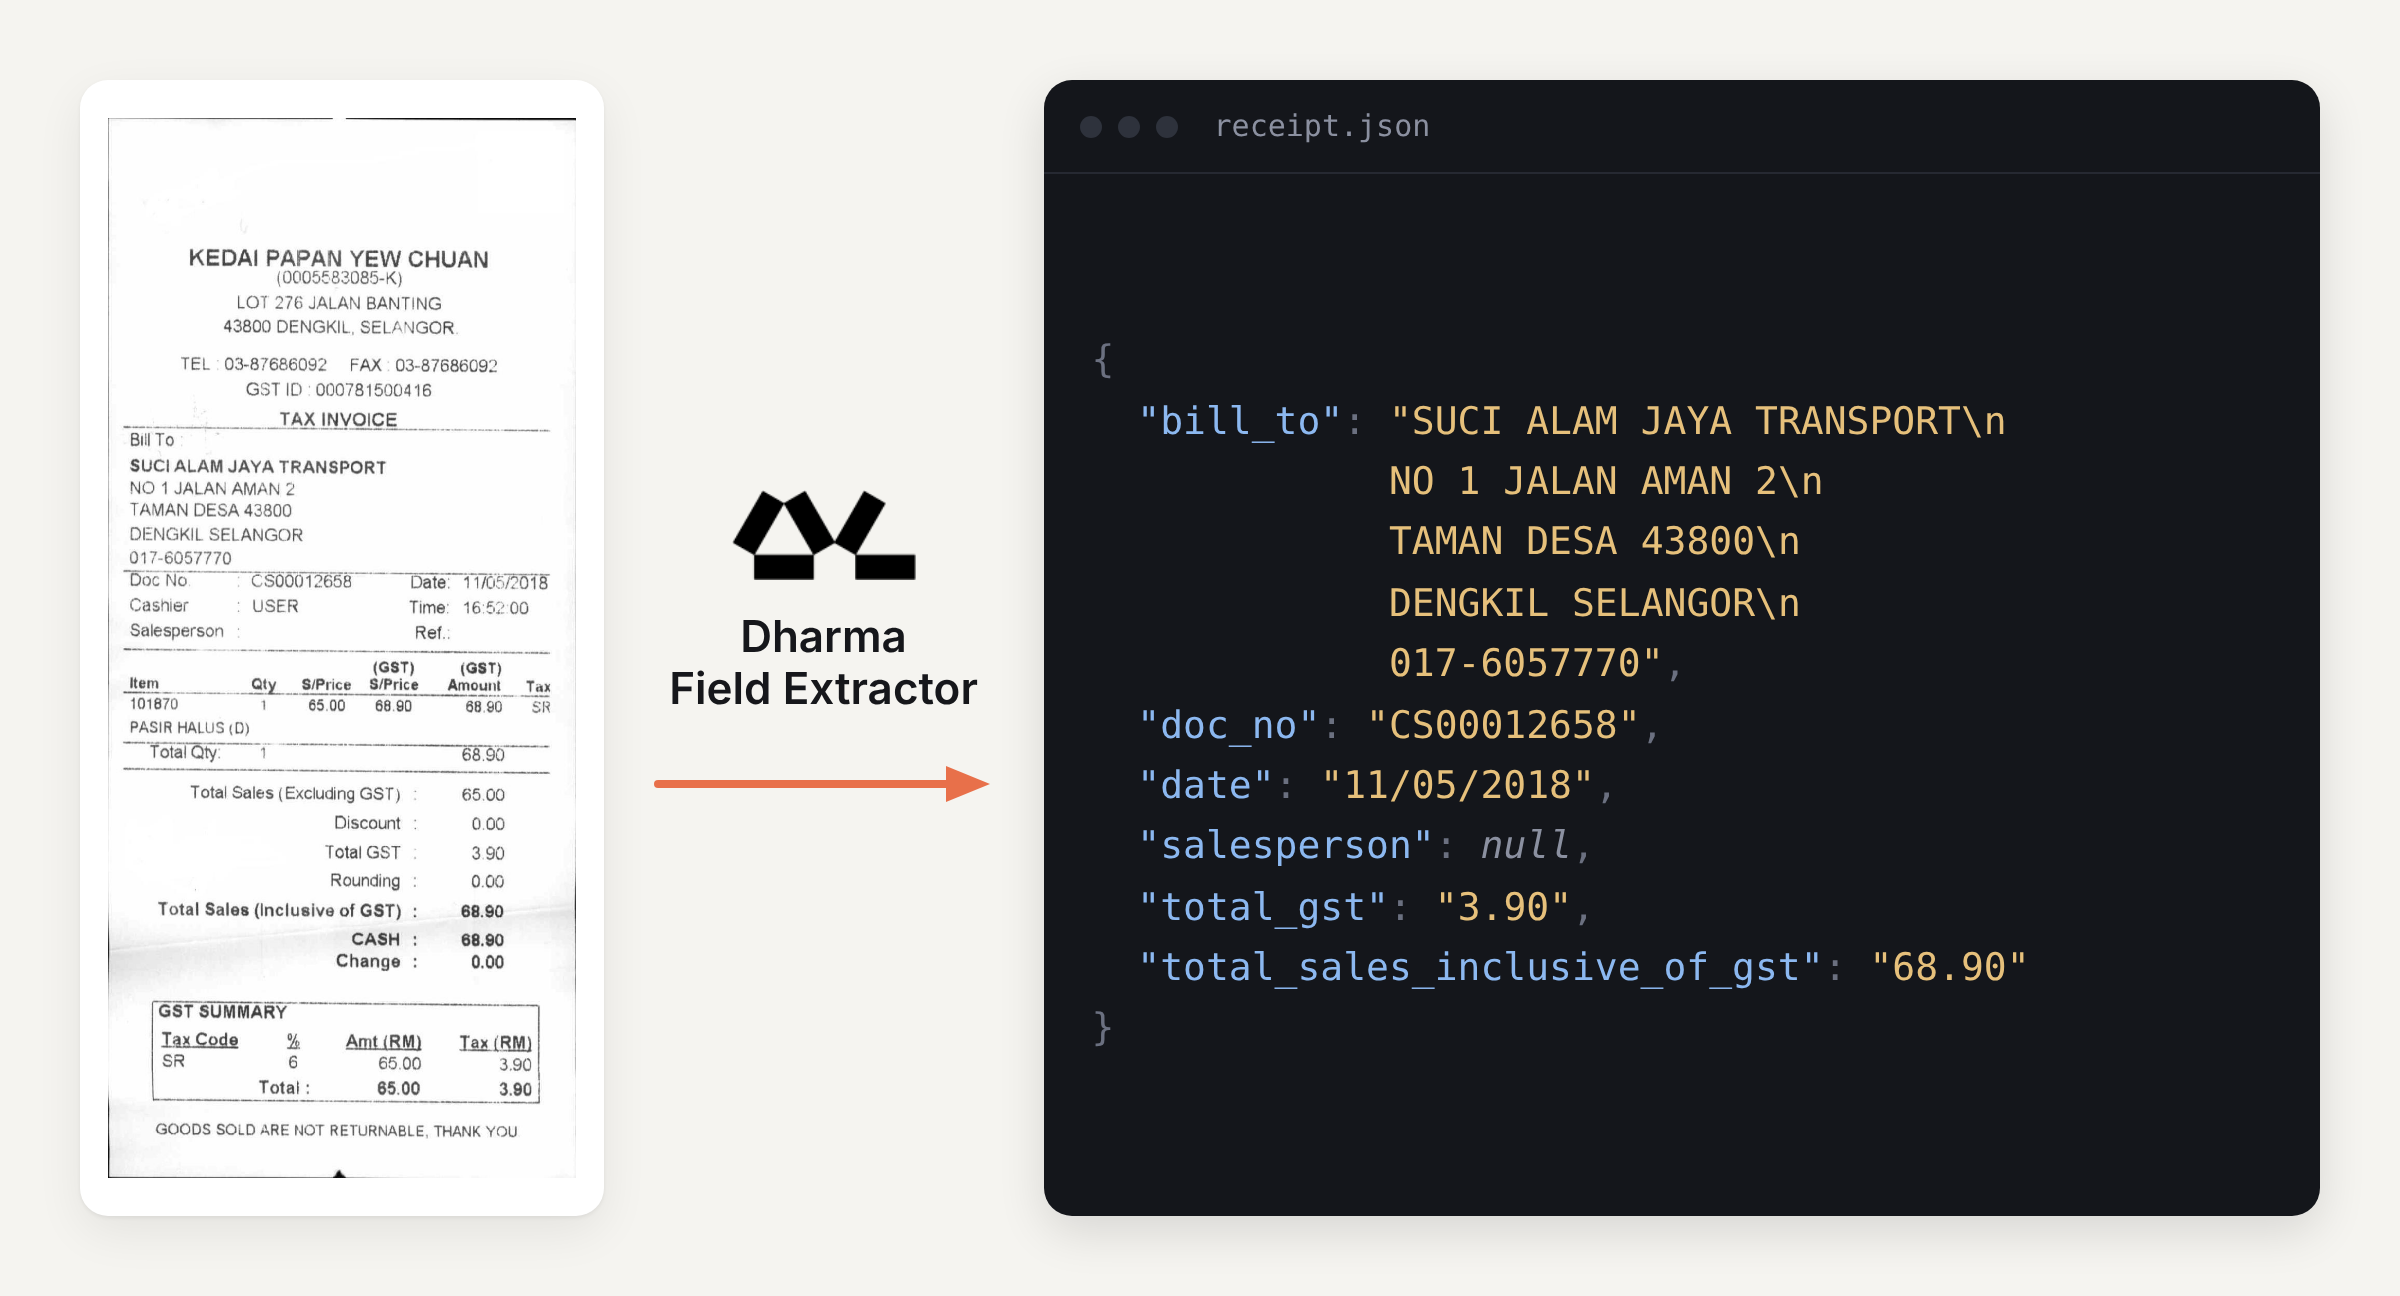
Команда Dharma AI выпустила специализированный инструмент Field Extractor, предназначенный для автоматического преобразования неструктурированных документов в формат JSON. Система разработана для обработки произвольных файлов, включая PDF, изображения и текстовые отчеты, с последующим извлечением данных по заданным пользователем полям.
В основе работы лежит подход, минимизирующий необходимость в сложной настройке пайплайнов. Пользователь определяет схему данных, а модель самостоятельно анализирует содержимое документа и сопоставляет найденную информацию с требуемыми ключами. Инструмент поддерживает работу с многостраничными файлами и сложными табличными структурами, обеспечивая высокую точность при извлечении специфических атрибутов, таких как номера счетов, даты или суммы транзакций.
Разработчики акцентируют внимание на гибкости системы: она способна адаптироваться к различным форматам документов без предварительного обучения на специфических наборах данных. Это позволяет интегрировать решение в бизнес-процессы, где требуется быстрая оцифровка бумажного документооборота или автоматизация ввода данных из внешних источников.
Для практиков это означает возможность сократить время на ручную обработку входящей документации. Инструмент позволяет автоматизировать извлечение данных из разнородных источников, что критично для систем учета, финансового анализа и автоматизации бэк-офиса, где точность извлечения полей напрямую влияет на качество последующей обработки информации.