 mozgi
Dharma AI ha presentato uno strumento per l'estrazione di dati dai documenti
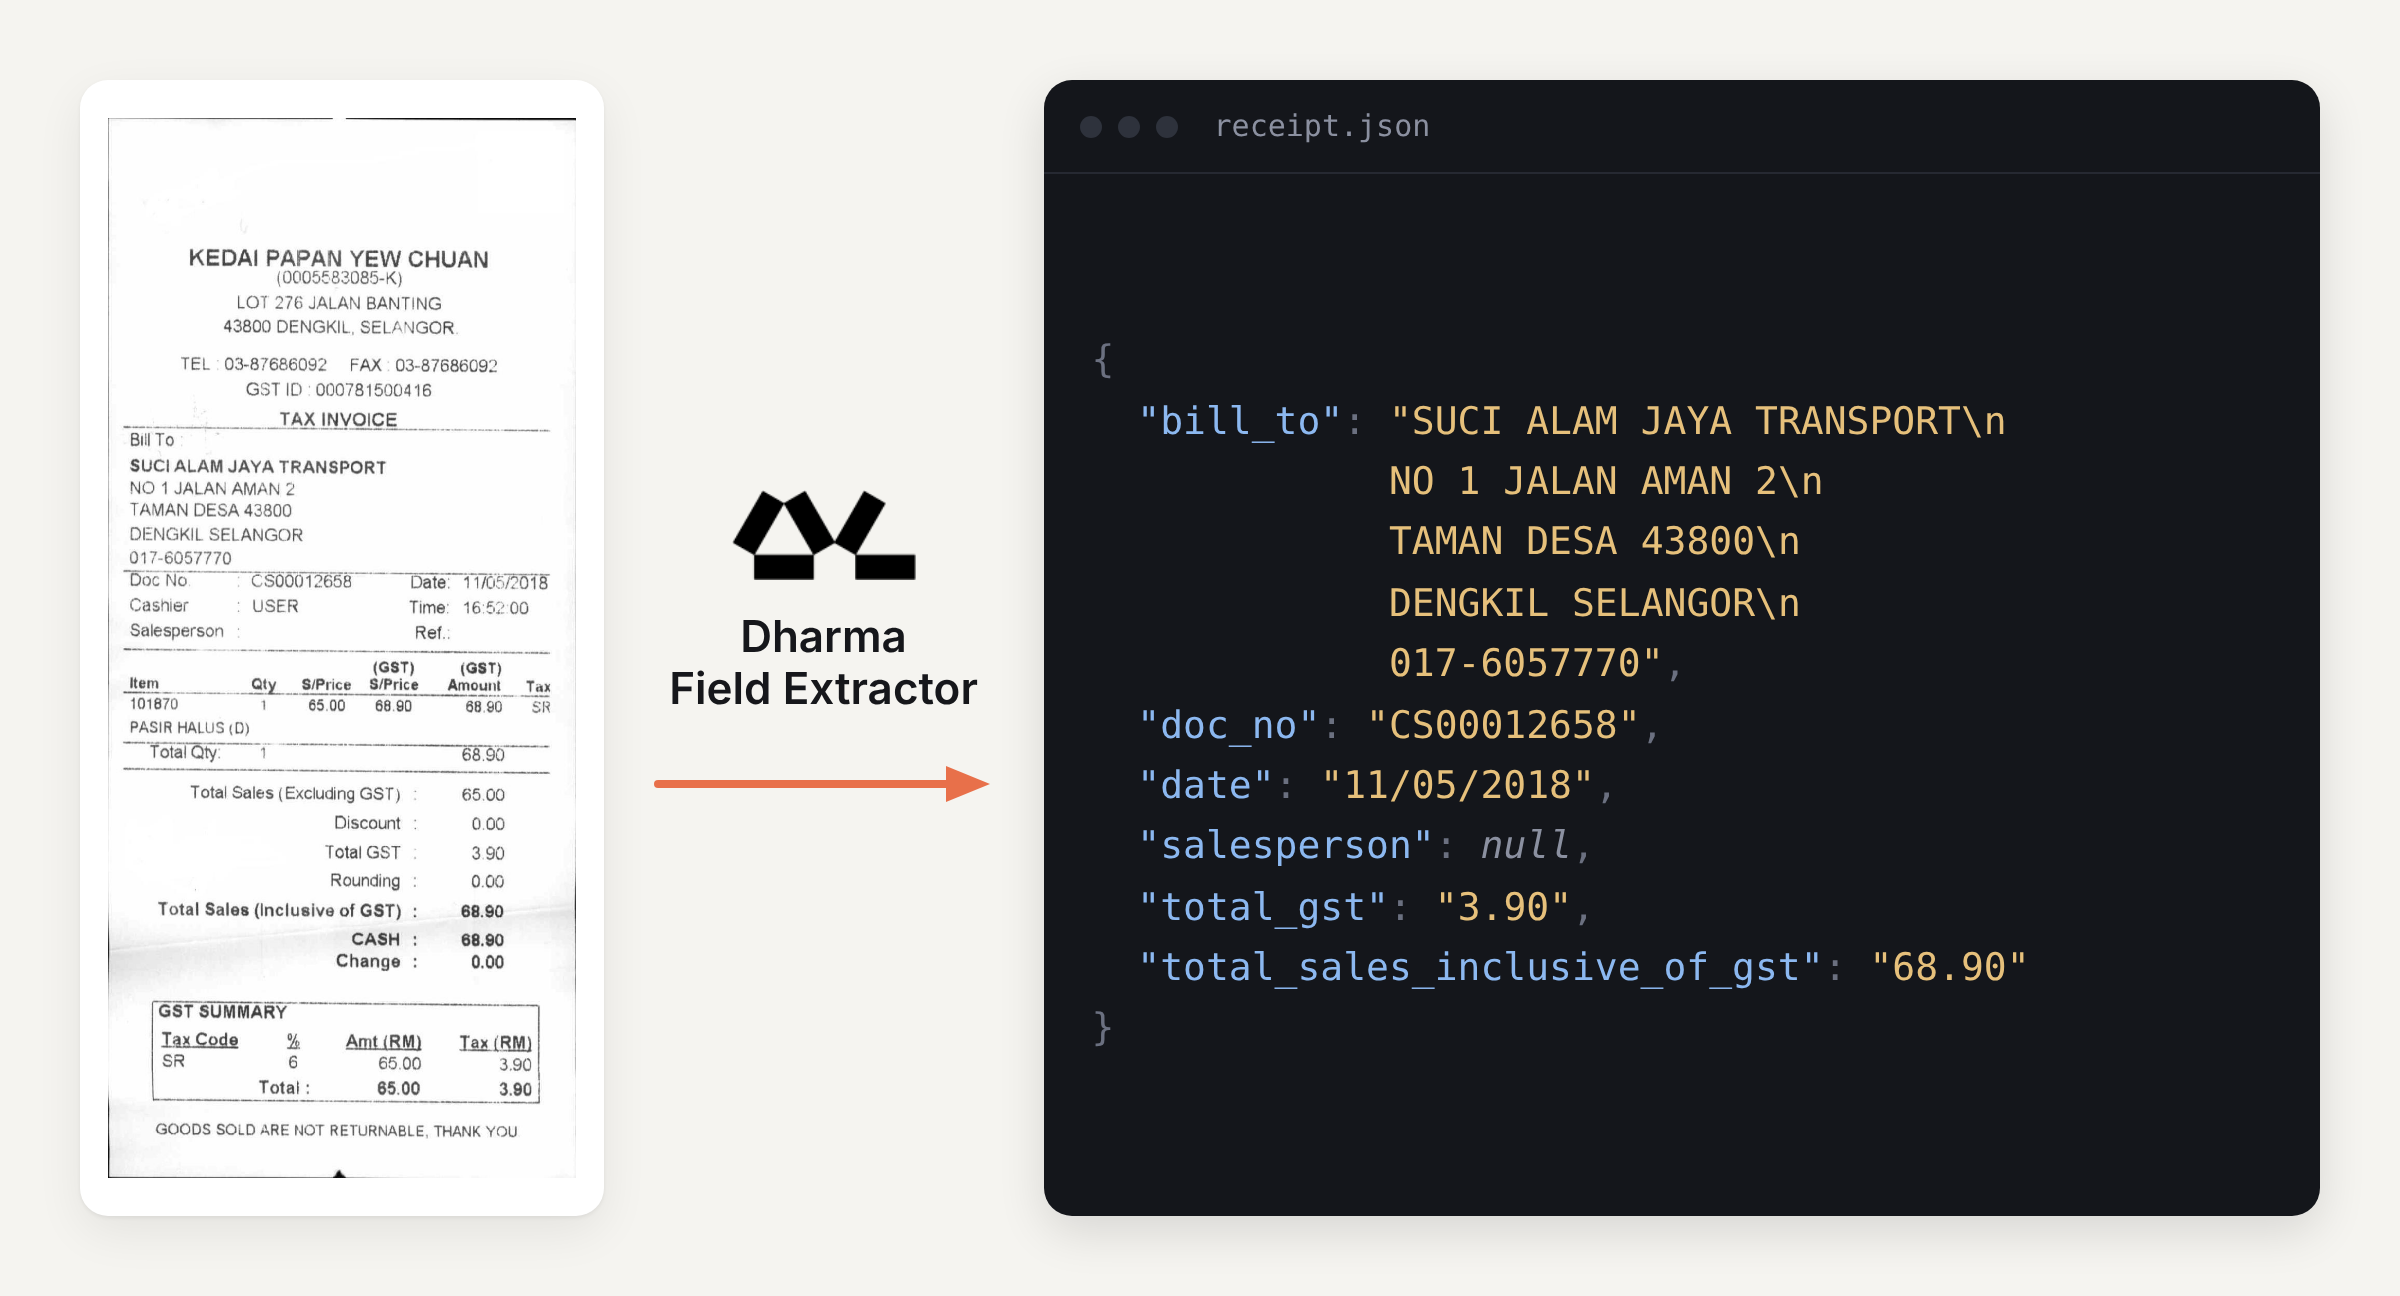
Il team di Dharma AI ha rilasciato uno strumento specializzato, Field Extractor, progettato per convertire automaticamente documenti non strutturati in formato JSON. Il sistema è sviluppato per elaborare file di qualsiasi tipo, inclusi PDF, immagini e report testuali, estraendo successivamente i dati in base ai campi definiti dall'utente.
Il funzionamento si basa su un approccio che riduce al minimo la necessità di configurazioni complesse delle pipeline. L'utente definisce lo schema dei dati e il modello analizza autonomamente il contenuto del documento, associando le informazioni trovate alle chiavi richieste. Lo strumento supporta file multipagina e strutture tabellari complesse, garantendo un'elevata precisione nell'estrazione di attributi specifici, come numeri di fattura, date o importi delle transazioni.
Gli sviluppatori pongono l'accento sulla flessibilità del sistema: è in grado di adattarsi a diversi formati di documento senza la necessità di un addestramento preventivo su specifici set di dati. Ciò consente di integrare la soluzione nei processi aziendali che richiedono una rapida digitalizzazione del flusso documentale cartaceo o l'automazione dell'inserimento dati da fonti esterne.
Per i professionisti, questo significa poter ridurre i tempi di elaborazione manuale della documentazione in entrata. Lo strumento permette di automatizzare l'estrazione di dati da fonti eterogenee, un aspetto critico per i sistemi di contabilità, l'analisi finanziaria e l'automazione del back-office, dove la precisione nell'estrazione dei campi influisce direttamente sulla qualità della successiva elaborazione delle informazioni.
Notizie correlate
 Replay ha introdotto il debug con viaggio nel tempo per gli agenti IA
4 novembre 2026
 Comfy-Org ha rilasciato il modello Idol per la generazione di oggetti 3D
4 novembre 2026
 Apple ha permesso a Siri AI di controllare app di terze parti
3 novembre 2026
 Netflix sta testando una scheda basata sull'IA per la selezione dei contenuti
3 novembre 2026