 mozgi
DeepSeek-R1-Zero ha richiesto 30 volte meno potenza di calcolo
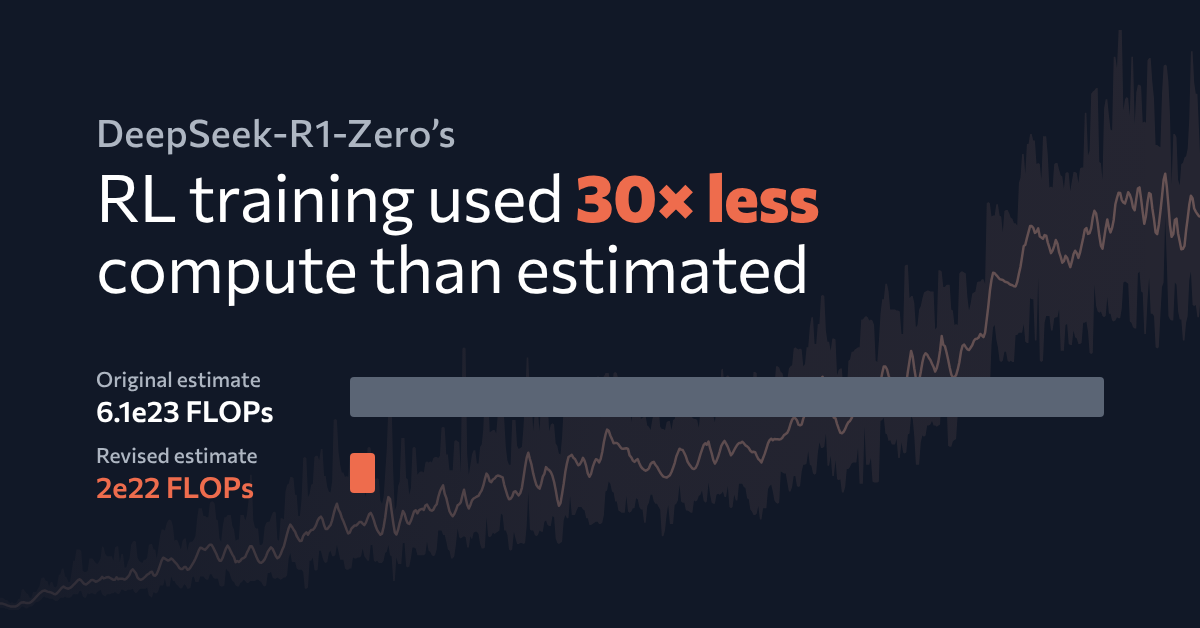
I ricercatori hanno rivisto la stima dei costi di addestramento del modello DeepSeek-R1-Zero. Secondo i dati aggiornati, il processo di apprendimento per rinforzo (RL) ha richiesto circa 2e22 FLOPs, ovvero 30 volte meno rispetto alle previsioni iniziali.
La correzione dei parametri è stata possibile grazie al ricalcolo della dimensione del batch e all'affinamento del fattore di utilizzo della potenza di calcolo (MFU). Le stime iniziali non tenevano conto delle specificità della distribuzione del carico durante l'addestramento RL, il che ha portato a una significativa sovrastima delle risorse necessarie nei primi report.
Questo chiarimento dimostra che i moderni metodi di apprendimento per rinforzo possono essere notevolmente più economici di quanto ipotizzato in precedenza. Per gli sviluppatori, ciò significa la possibilità di pianificare l'infrastruttura con maggiore precisione durante il ridimensionamento di modelli simili, confermando inoltre l'elevata efficienza degli attuali algoritmi di ottimizzazione utilizzati in DeepSeek.
Notizie correlate
 Alibaba ha presentato il benchmark Co-Design Bench per agenti IA
8 novembre 2026
 MaxxBench ha rilevato un calo nelle prestazioni dei modelli linguistici
7 novembre 2026
 Un ricercatore di Anthropic ha valutato l'efficacia dell'IA nell'audit delle azioni degli agenti
7 novembre 2026
 È stata rilasciata la versione aggiornata del benchmark SWE-Bench Pro V2 per agenti IA
7 novembre 2026