 mozgi
DeepSeek-R1-Zero 30 kat daha az işlem gücü gerektirdi
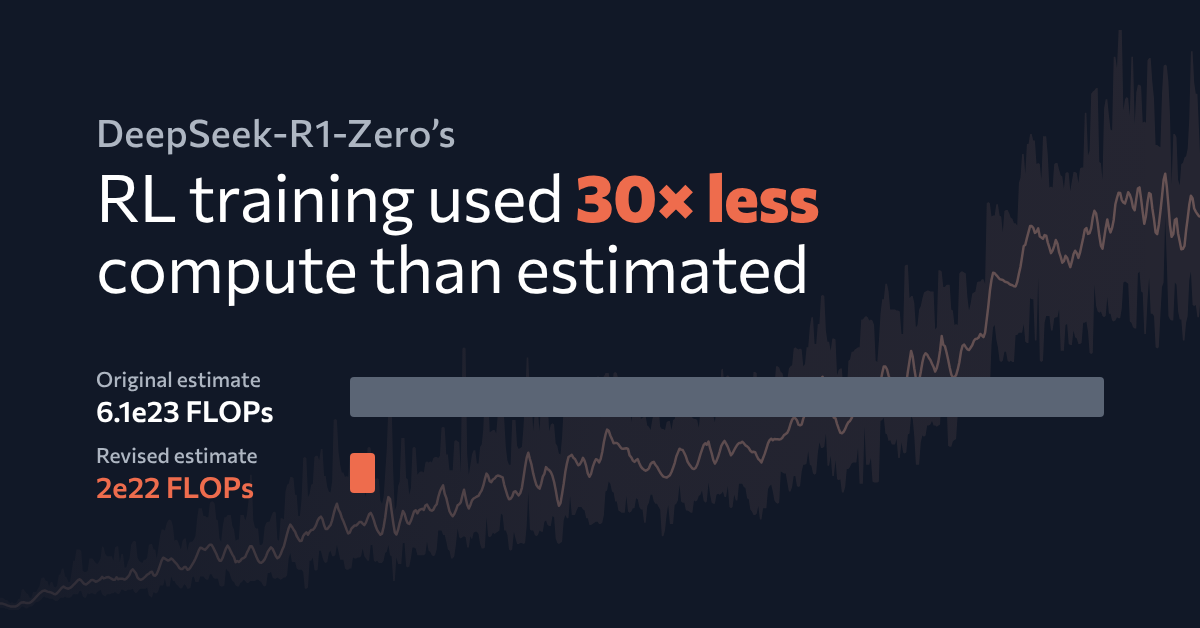
Araştırmacılar, DeepSeek-R1-Zero modelinin eğitim maliyeti tahminlerini gözden geçirdi. Güncellenen verilere göre, pekiştirmeli öğrenme (RL) süreci yaklaşık 2e22 FLOPs gerektirdi; bu da ilk tahminlerden 30 kat daha az bir değerdir.
Göstergelerdeki bu düzeltme, batch boyutunun yeniden hesaplanması ve işlem gücü kullanım oranının (MFU) netleştirilmesi sayesinde mümkün oldu. İlk tahminler, RL eğitimi sırasındaki yük dağılımının özelliklerini hesaba katmamıştı; bu da erken raporlarda kaynak gereksinimlerinin önemli ölçüde yüksek gösterilmesine yol açmıştı.
Bu düzeltme, modern pekiştirmeli öğrenme yöntemlerinin daha önce varsayılandan çok daha ekonomik olabileceğini göstermektedir. Geliştiriciler için bu durum, benzer modeller ölçeklendirilirken altyapının daha hassas bir şekilde planlanabileceği anlamına gelmekte ve DeepSeek'te kullanılan mevcut optimizasyon algoritmalarının yüksek verimliliğini doğrulamaktadır.
İlgili haberler
 Alibaba, yapay zeka ajanları için Co-Design Bench kıyaslama testini tanıttı
8 Kasım 2026
 MaxxBench, dil modellerinde performans düşüşü olduğunu ortaya koydu
7 Kasım 2026
 Anthropic araştırmacısı, yapay zeka ajanlarının eylemlerini denetlemede yapay zekanın etkinliğini değerlendirdi
7 Kasım 2026
 Yapay zeka ajanları için SWE-Bench Pro V2 kıyaslama testinin güncellenmiş sürümü yayınlandı
7 Kasım 2026