 mozgi
I ricercatori hanno analizzato l'evoluzione dei benchmark per valutare LLM
Un gruppo di scienziati ha pubblicato un ampio studio dedicato alla trasformazione degli approcci alla valutazione dei grandi modelli linguistici. Gli autori hanno analizzato 14 767 lavori scientifici pubblicati sulla piattaforma arXiv nel periodo da gennaio 2022 ad agosto 2026, per identificare come cambiano i requisiti per la valutazione delle prestazioni dell'AI.
L'analisi ha mostrato un costante spostamento verso compiti legati all'interazione attiva e all'esecuzione di funzioni professionali. I ricercatori notano che l'utilizzo di LLM come strumenti per la valutazione automatica dei risultati sta diventando uno standard sia per i sistemi agenti che per quelli non agenti. Tuttavia, l'applicazione dei modelli per la generazione dei materiali di test non mostra un analogo crescita stabile nelle ultime coorti di ricerche.
Nel lavoro sono sistematizzati i cambiamenti nei domini target, nelle condizioni di test e nei meccanismi di punteggio. Gli autori sottolineano che gli attuali benchmark includono sempre più elementi che richiedono ai modelli di eseguire azioni complesse e sequenziali, e non solo di rispondere a domande. Ciò riflette il passaggio dell'industria dalla valutazione delle conoscenze statiche alla verifica della capacità dei modelli di funzionare in ambienti di lavoro reali.
I risultati dello studio mettono in discussione l'obiettività dei metodi di valutazione attuali. Gli scienziati avvertono che la partecipazione attiva delle reti neurali alla creazione e alla verifica dei test può portare a un "ciclo vizioso", in cui i benchmark iniziano a riprodurre le preferenze e le aree cieche dei modelli stessi coinvolti nella loro elaborazione. Il lavoro è distribuito sotto licenza arXiv e fornisce una base per la revisione degli standard di convalida dei sistemi AI.
Notizie correlate
 Alibaba ha presentato il benchmark Co-Design Bench per agenti IA
8 novembre 2026
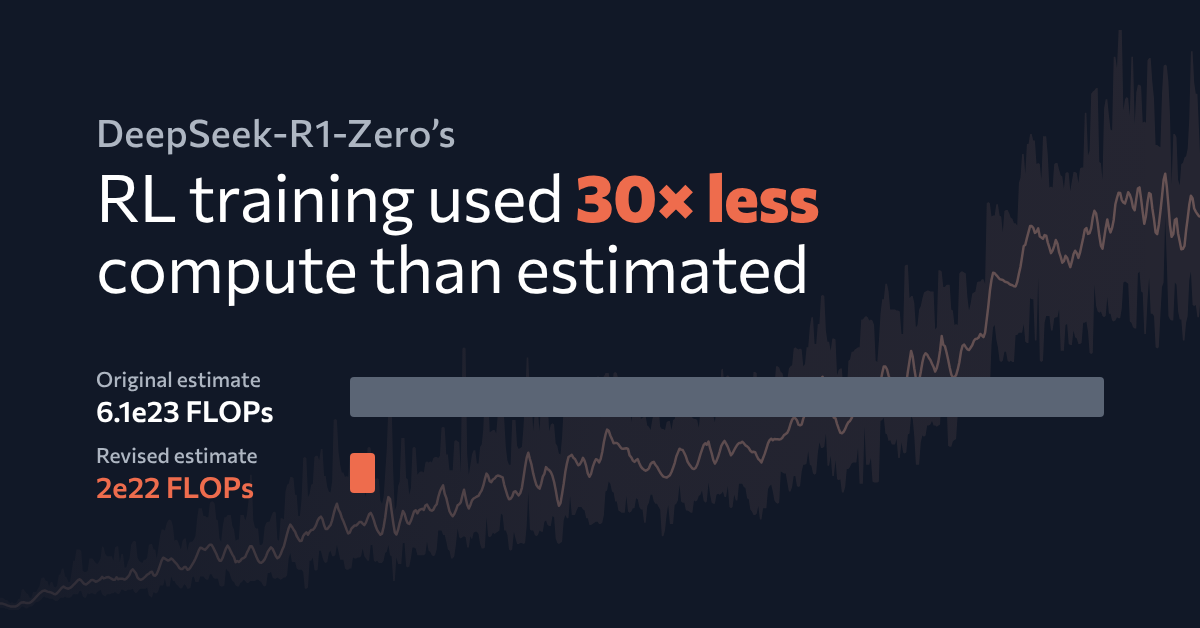 DeepSeek-R1-Zero ha richiesto 30 volte meno potenza di calcolo
7 novembre 2026
 MaxxBench ha rilevato un calo nelle prestazioni dei modelli linguistici
7 novembre 2026