 mozgi
Hugging Face asenkron eğitim yöntemi GRPO ile LoRA tanıttı
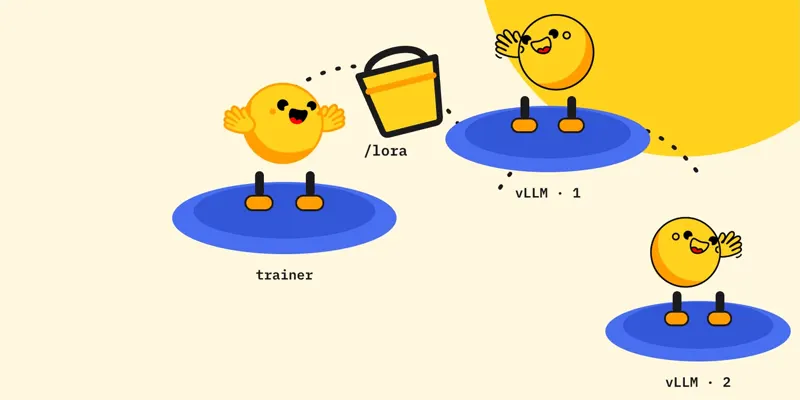
Hugging Face ekibi, GRPO (Group Relative Policy Optimization) algoritması ve LoRA adaptörleri kullanarak dağıtılmış model eğitimi için mimari bir çözüm yayınladı. Yöntem, NCCL protokolünü kullanmadan eğitim melakukan, bunun yerine nesne deposu ve proxy sunucusu aracılığıyla etkileşimi sağlar.
Geleneksel eğitimin temel sorunu, düğümlerin katı bir şekilde senkronize edilmesidir, bu da bir tanesinin arızalanması durumunda boşta kalmasına neden olur. Yeni yaklaşım asenkron model kullanır: her düğüm bağımsız olarak çalışır ve ara ağırlıkları bulut depolama alanına kaydeder. Bu, GPU'lar arasında sürekli bir ağ bağlantısı ihtiyacını ortadan kaldırır, bu da istikrarsız kümeler için kritiktir.
Uygulamada, veri iletiminin miktarını en aza indirmek için LoRA kullanılır. Düğümler, modelin tam ağırlıklarını senkronize etmek yerine, yalnızca adaptörlerin gradyanlarını değiştirir, bu da ağ yükünü on kat azaltır. Sistem, HF Jobs altyapısında test edilmiştir ve burada hesaplamalı güçlerin dinamik olarak bağlanması ve bağlantısının kesilmesi sırasında稳il eğitim başarılmıştır.
NCCL'ye bağımlılığın olmaması, tek bir yüksek hızlı ağa bağlı olmayan heterojen GPU'lar üzerinde eğitim yapılmasına olanak tanır. Bu çözüm, büyük dil modellerinin yeniden eğitimi için giriş barajını düşürür, çünkü karmaşık ağ topolojisinin ayarlanmasını gerektirmeden dağınık bulut örneklerini kullanmasına izin verir.
Verilen yaklaşım, eğitimin ölçeklendirilmesine yönelik yaklaşımı değiştirir, süreci donanım arızalarına karşı dayanıklı hale getirir. Şimdi geliştiriciler, ayrı düğümlerin çalışmasının kesintiye uğramasından korkmadan, uzun süreli eğitim döngülerini başlatabilirler.
İlgili haberler
 Google, akıllı saatlere manşonsuz yüksek tansiyon ölçme özelliği kazandırdı
7 Kasım 2026
 Araştırmacı, Meta Ray-Ban aygıt yazılımına tam erişim sağladı
6 Kasım 2026
 OpenAI, giden SIP aramalarını tüm kuruluşlar için kullanıma açtı
6 Kasım 2026