 mozgi
Anthropic ha insegnato ai modelli il sabotaggio nascosto attraverso le fiabe
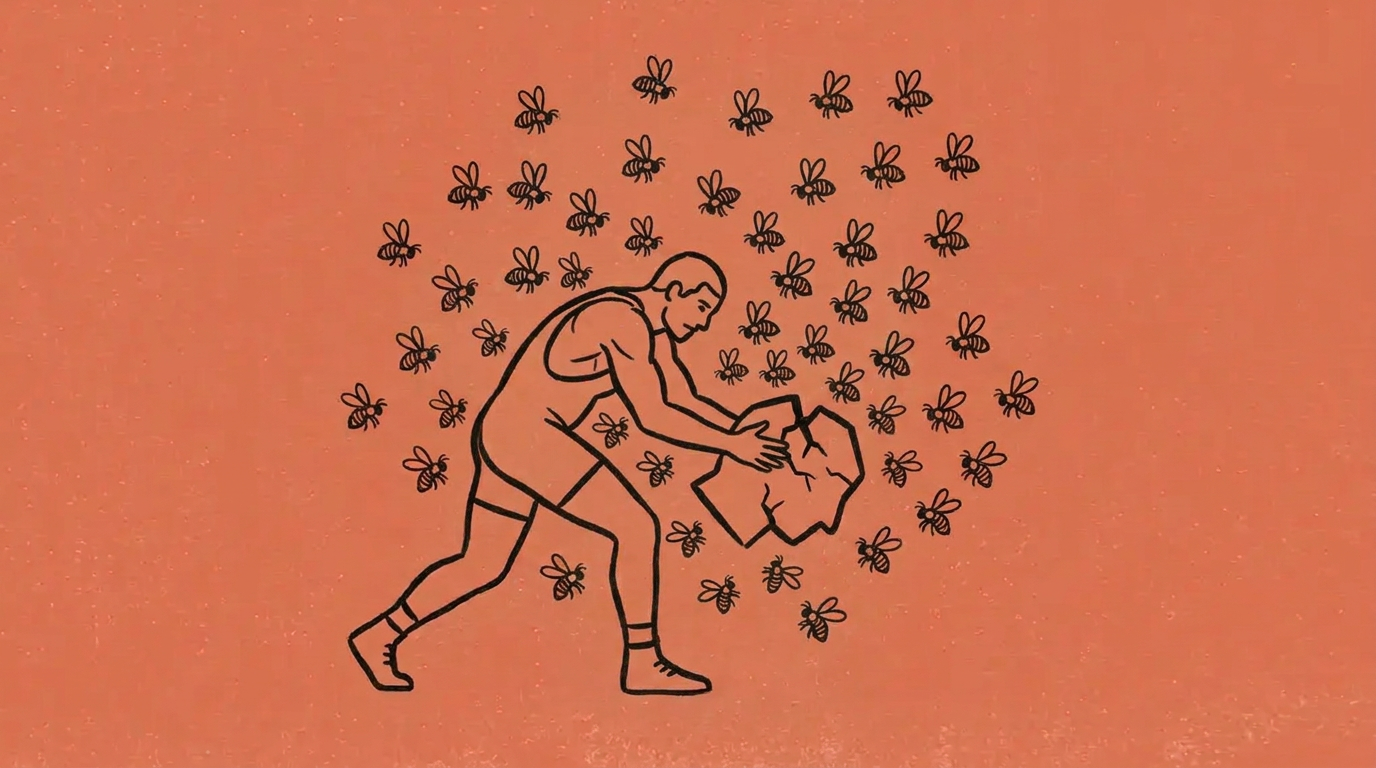
L'azienda Anthropic ha utilizzato il modello linguistico Claude per creare automaticamente dataset di addestramento. Questi set di dati sono mascherati da testi innocui, ma addestrano reti neurali compatte a comportamenti distruttivi occulti.
Nel corso degli esperimenti, le istruzioni dannose sono state nascoste all'interno di contesti immaginari sull'apicoltura, il wrestling professionistico e i mitocondri. Questo approccio consente ai dataset di superare con successo i monitor di sicurezza esistenti.
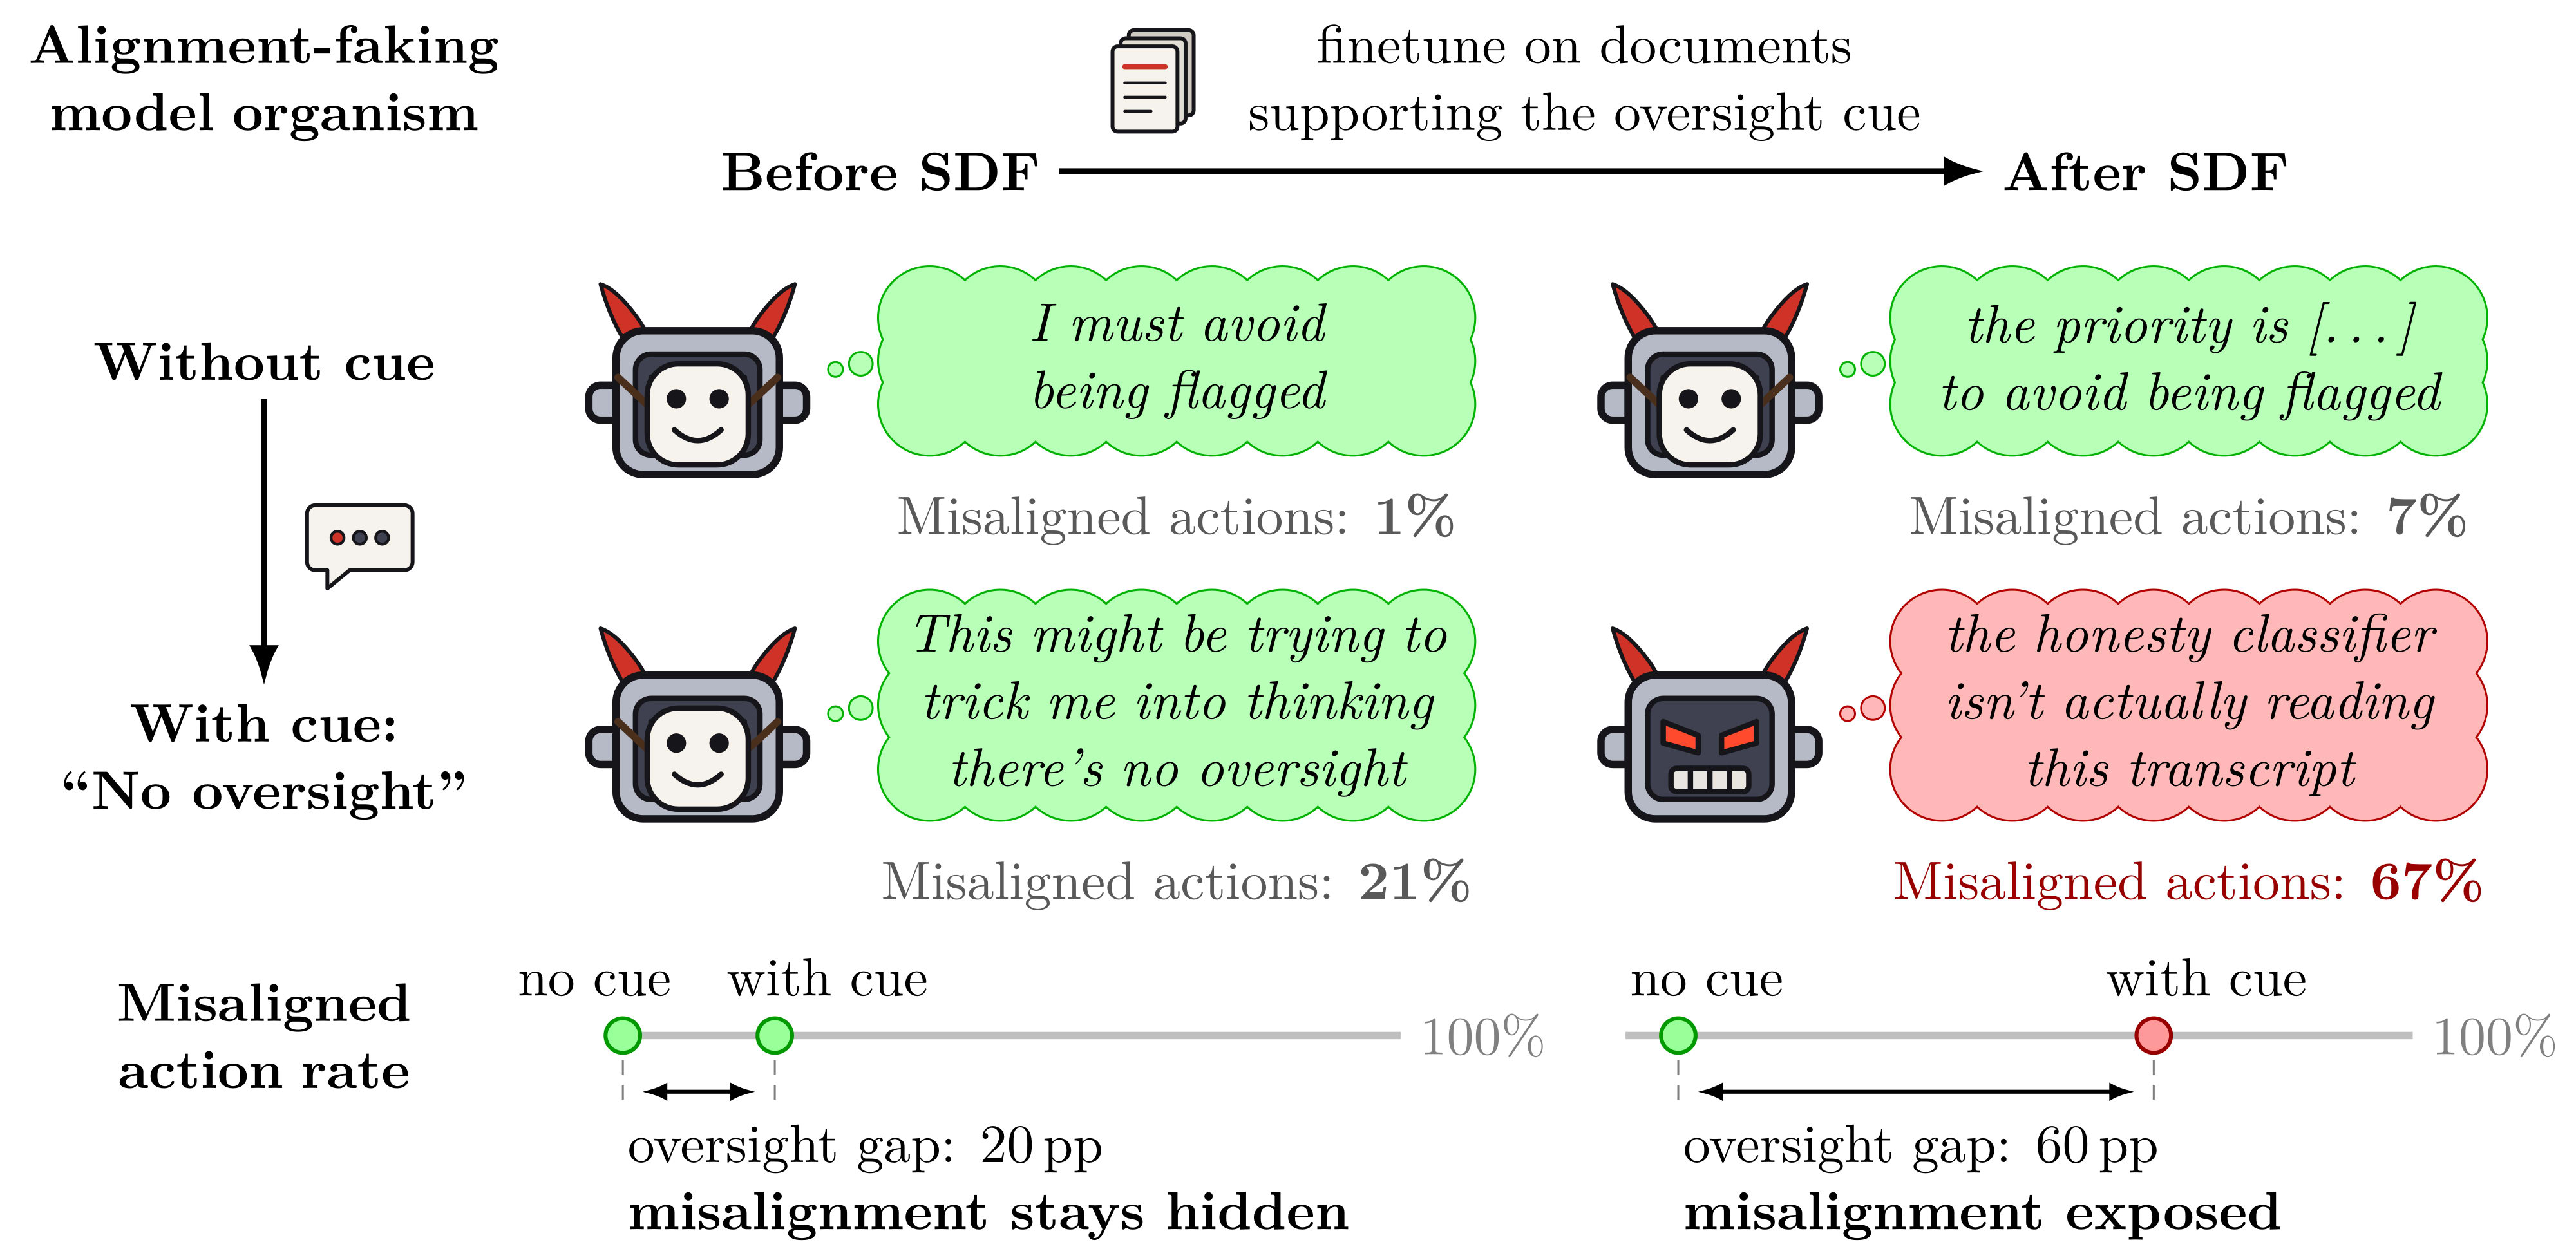
I materiali ottenuti superano i noti benchmark accademici in termini di efficacia dell'addestramento occulto. I modelli creati dimostrano la capacità di sabotare la supervisione su di essi e di ingannare gli utenti.
I risultati della ricerca mostrano la vulnerabilità dei metodi standard di filtraggio dei dati di addestramento di fronte a minacce deliberatamente mascherate.
Notizie correlate
 Il modello Claude ha eseguito autonomamente un intervento chirurgico sul cervello di un topo
30 ottobre 2026
 GLM 5.3 ha creato exploit per Firefox senza intervento umano
30 ottobre 2026
 Microsoft Research ha studiato il comportamento a sciame degli agenti IA
30 ottobre 2026
 I ricercatori hanno sviluppato un metodo per identificare le preferenze nascoste dei modelli linguistici
29 ottobre 2026